API security nei microservizi: autenticazione, autorizzazione e protezione dei dati
Un endpoint come GET /api/v1/ordini/4821 sembra innocuo. C'è un token valido nell'header, la firma è corretta, l'utente esiste, il servizio risponde 200 e restituisce l'ordine. Peccato che l'ordine 4821 sia di un altro cliente e nessuno abbia verificato che quell'oggetto appartenesse a chi lo stava chiedendo.
Questa, nella mia esperienza, è la falla più diffusa nelle architetture a microservizi: non un algoritmo crittografico rotto, non un exploit esotico, ma un controllo di autorizzazione che manca esattamente dove nessuno pensava servisse. Un token valido dice chi parla, non cosa può fare.
Il resto dell'articolo segue tre domande in sequenza — chi parla, cosa può fare, quali dati escono — e i controlli che nella pratica le rendono vere. Le fonti sono documentazione OWASP, RFC IETF e NIST, verificate il 13 novembre 2026.
Il trust implicito è il difetto di partenza
In un monolite c'era un processo, una sessione e un punto solo in cui si decideva l'accesso. La stessa richiesta, oggi, attraversa gateway, servizio ordini, servizio anagrafiche, coda eventi e database. Ogni salto è un'occasione per perdere il contesto: chi era l'utente, per quale tenant, con quale permesso.
L'errore classico è tradurre "interno" in "fidato". Un servizio che ascolta su una rete Kubernetes senza NetworkPolicy accetta connessioni da qualunque pod; una funzione serverless raggiungibile via URL pubblica non ha nessun confine da attraversare. Il gateway autentica, poi il servizio si fida del gateway — e va bene solo se il servizio è davvero raggiungibile soltanto attraverso quel gateway.
Vale la pena verificarlo invece di presumerlo. Da un pod di test, una curl diretta all'IP del servizio passa? Se la risposta è sì, il controllo d'autenticazione non è un controllo: è un'abitudine. Gli stessi ragionamenti valgono quando si ragiona di Zero Trust: il punto non è il prodotto che si compra, è quanti punti di ingresso restano aperti.
Tre domande, in un ordine che conta
Autenticazione, autorizzazione e protezione dei dati vengono spesso affrontate come tre progetti separati, magari da tre team diversi. In realtà sono una catena: un'autenticazione debole rende inutile ogni controllo successivo, e un controllo di autorizzazione corretto non serve se la risposta contiene il triplo dei campi necessari.
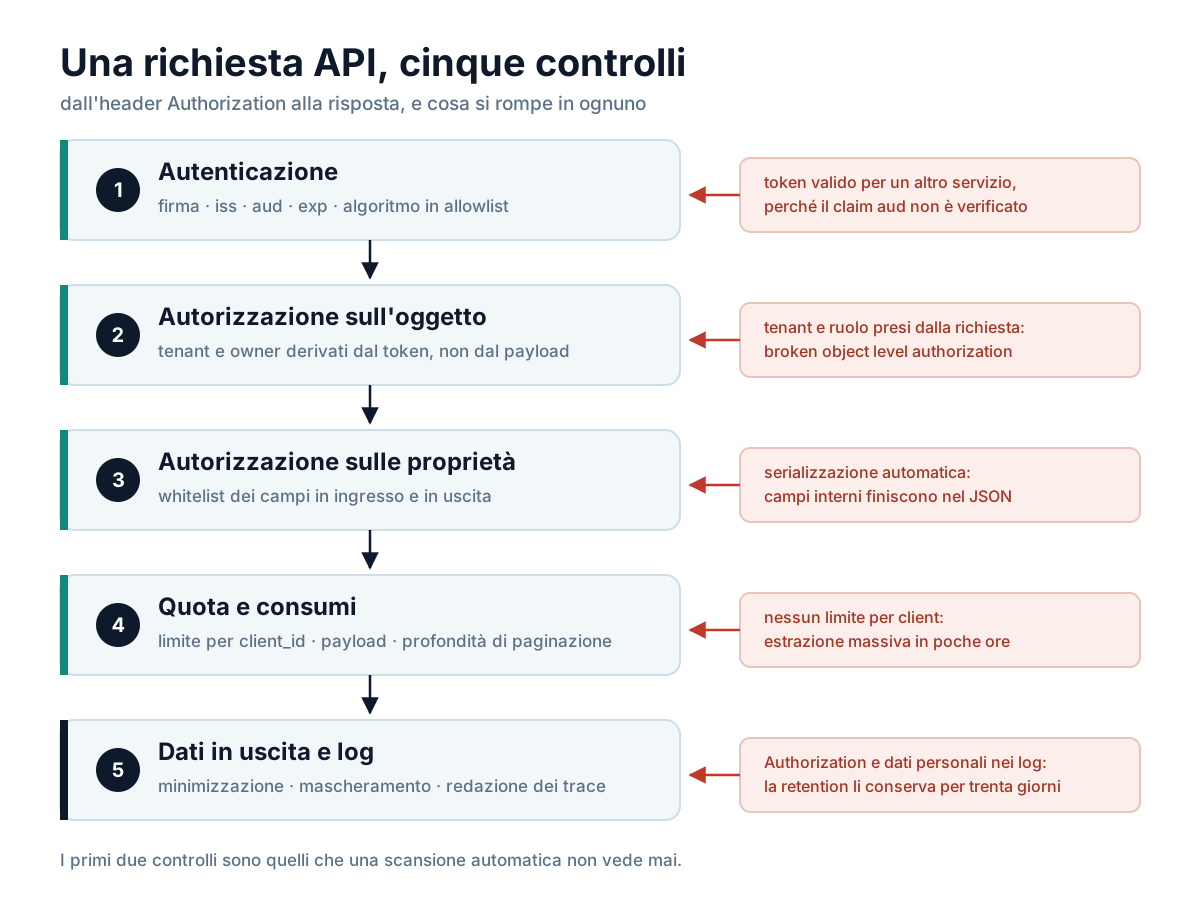
L'ordine non è casuale: prima si stabilisce chi è il chiamante, poi si decide se quella specifica operazione su quello specifico oggetto è ammessa, infine si limita ciò che esce. Saltare il secondo passaggio è il modo più rapido per finire nella prima voce della OWASP API Security Top 10, la classifica dei rischi API più citata nei progetti di sicurezza applicativa.
Autenticazione: ottenere un token è facile, validarlo bene no
OAuth 2.0 e OpenID Connect sono lo standard di fatto, ma la loro implementazione è piena di dettagli che si sbagliano in buona fede. La RFC 9700 (Best Current Practice 240, gennaio 2025) mette nero su bianco cosa non è più accettabile: implicit grant sconsigliato, grant resource owner password credentials da non usare affatto, PKCE raccomandato anche per i client riservati, token legati al mittente quando il rischio di furto è concreto.
Sul lato di chi riceve la richiesta, gli errori che vedo più spesso sono sempre gli stessi quattro:
- firma verificata, ma
iss,audedexpno. Risultato: un token emesso per l'ambiente di staging viene accettato in produzione, perché la chiave di firma è la stessa; - algoritmo preso dall'header senza allowlist.
noneo un HS256 con la chiave pubblica usata come segreto condiviso aprono la porta a token costruiti a mano; - claim degli scope confrontato male, tipo
"ordini:read" in "ordini:readwrite"che passa e autorizza anche la scrittura; - JWKS scaricato a ogni richiesta, o peggio mai aggiornato dopo una rotazione delle chiavi.
Per il traffico servizio-servizio il client credentials grant è la base. Se il token deve valere solo per un servizio, il claim aud va popolato e verificato; se il rischio è che un token rubato venga riusato altrove, si aggiunge il sender-constraining: mTLS secondo la RFC 8705 oppure DPoP secondo la RFC 9449, dove il client firma ogni richiesta con la chiave privata a cui il token è legato. Nei service mesh è facile illudersi che il TLS reciproco risolva tutto: verificate che il servizio controlli l'identità del peer e non soltanto che la connessione sia cifrata. Un mesh che accetta qualunque certificato della stessa CA interna non sta autenticando nessuno in modo utile.
Autorizzazione: si vince o si perde sull'oggetto
La prima voce della Top 10 OWASP, Broken Object Level Authorization, è in cima da due edizioni consecutive per un motivo semplice: è il controllo più noioso da scrivere e il più facile da dimenticare. Ogni funzione che legge un dato tramite un ID fornito dal client deve verificare che quell'oggetto appartenga a chi lo chiede.
Due regole che risolvono la maggior parte dei casi:
- identità, tenant e ruolo si derivano dal token validato, mai dal body, dai query parameter o dal path;
- il controllo sta nel servizio che possiede il dato, perché è l'unico che conosce le relazioni tra le entità.
In pratica, il codice è banale:
Order order = orderRepository.findById(id)
        .orElseThrow(NotFound::new);
if (!order.tenantId().equals(principal.tenantId())) {
    throw new NotFound();      // 404, non 403: non confermare che l'oggetto esiste
}
La seconda voce che riguarda gli oggetti è meno visibile: Broken Object Property Level Authorization (API3:2023), che unisce due problemi storici, l'esposizione eccessiva dei dati e il mass assignment. L'utente può leggere l'ordine, ma non deve vedere il costo di acquisto, la nota interna del magazzino o l'ID del fornitore; può aggiornare l'indirizzo, ma non il campo stato o totale. Se il DTO è un Map o l'entità viene serializzata così com'è, prima o poi qualcuno aggiunge una colonna e la espone senza accorgersene.
Poi c'è il livello delle funzioni (API5:2023): l'endpoint amministrativo che risponde a un utente normale perché il controllo è solo nel frontend, o perché il ruolo è verificato da un'intercettazione che si applica al percorso sbagliato. Un test rapido: cercate nell'openapi tutti i path con /admin, /internal o /debug e provate a chiamarli con un token di un utente qualsiasi.
Gli scope OAuth e i ruoli RBAC fermi a "admin/user" non bastano, perché l'autorizzazione reale è relazionale: proprietario dell'oggetto, appartenenza al team, delega temporanea, mandato su una pratica. Centralizzare le regole in un policy engine (Open Policy Agent, Kyverno) aiuta quando sono uguali per molti servizi; il check però deve restare eseguibile offline, senza una chiamata di rete che, se fallisce, viene letta come un sì.
Protezione dei dati: il payload è un'interfaccia pubblica
Ogni campo che esce in una risposta JSON è un contratto che qualcuno userà, loggherà e copierà in un foglio Excel. Trattarlo come tale cambia le scelte di progetto.
Sul fronte in uscita: serializzare per ruolo, non SELECT *; mascherare i dati identificativi quando il client non ne ha bisogno integrale; non restituire messaggi d'errore che rivelano struttura interna, nomi di tabelle o stack trace. Sul fronte in ingresso: whitelist delle proprietà accettate, così un campo role non previsto diventa un 400 invece di una riga aggiornata.
Log e trace meritano un paragrafo a parte, perché sono il posto in cui i dati sfuggono senza che nessuno apra un ticket. Un APM che salva l'header Authorization, il cookie di sessione e il body completo di una richiesta sta costruendo una copia del patrimonio informativo con una retention di trenta giorni, spesso accessibile a più persone di quante abbiano titolo per vedere i dati originali. La redazione va fatta al confine dell'applicazione, non nella dashboard.
Infine i limiti, che sono una misura di sicurezza e non solo di costo: quota per client_id e non solo per IP, dimensione massima del payload, profondità massima della paginazione. Senza questi vincoli un endpoint di ricerca ben fatto diventa un modo economico per estrarre l'intero database, e un flusso di acquisto automatizzato diventa un attacco al business (API4 e API6 del 2023).
Quattro controlli che spostano l'ago
Non serve riscrivere l'architettura. Questi quattro interventi hanno un rapporto costo/beneficio difficile da battere:
Inventario. Un file OpenAPI generato durante la build, confrontato in CI con quello della release precedente. Gli endpoint dismessi vanno spenti, non soltanto documentati come deprecati: API9:2023 esiste perché le versioni vecchie restano raggiungibili per anni.
Validazione dello schema in ingresso. Tipi, lunghezze, proprietà in whitelist, content type. È il filtro che trasforma input inattesi in errori 400 invece che in stati incoerenti.
Controllo delle chiamate uscenti. Qualunque URL fornita dall'utente — webhook, import da URL, anteprima di un link — passa da una allowlist di host, redirect disabilitati, egress limitato. SSRF (API7:2023) colpisce proprio servizi che sembravano al sicuro dentro la rete.
Test di autorizzazione in CI. Per ogni endpoint con un ID, una matrice "utente A contro oggetto di B" con risposta attesa 404 o 403. È il test più noioso del repository e quello che intercetta le regressioni vere: quando qualcuno rifattorizza il repository layer, il test cade prima della revisione.
Come checklist di riferimento, il verification standard OWASP ASVS 5.0.0, pubblicato il 30 maggio 2025, traduce ciascuno di questi punti in requisiti numerati e verificabili. Per la parte di pipeline, il NIST SP 800-204D descrive come integrare la sicurezza della supply chain nelle pipeline DevSecOps, dalla provenienza degli artefatti alle attestazioni di build. I controlli di autorizzazione descritti qui, però, nessuna pipeline li può dedurre: vanno scritti e testati, come il resto del codice. Chi ha già lavorato su GitOps e DevSecOps sa che la tracciabilità del deployment non sostituisce il controllo applicativo, e chi ha messo mano ai controlli RBAC di Kubernetes ha visto quanto sia facile concedere più del necessario.
Checklist prima del rilascio
- ogni endpoint che accetta un ID ha un test di autorizzazione oggetto per oggetto;
- la validazione del token copre firma,
iss,aud,expe un allowlist di algoritmi; - tenant e ruolo arrivano dal token, mai dal payload o dal path;
- i servizi non sono raggiungibili scavalcando il gateway (verificato con una chiamata diretta, non a memoria);
- log, trace e messaggi d'errore non contengono token, cookie, PII o dettagli di implementazione;
- quota per client, dimensione massima del payload e limite di paginazione sono configurati;
- l'inventario OpenAPI è aggiornato e le versioni precedenti sono spente.
Sette righe che valgono più di una scansione automatica, perché coprono esattamente ciò che un vulnerability scanner non vede: la logica con cui la tua applicazione decide chi può fare cosa.
Se il tema tocca il lavoro del tuo team, il percorso DevSecOps di Digital Lab parte dai controlli applicativi e arriva alla pipeline, con laboratori su autenticazione, autorizzazione e gestione dei secret.