Kubernetes security: RBAC, Network Policy e gestione sicura dei secret
Un cluster Kubernetes appena installato funziona. È anche, quasi sempre, un cluster aperto: ogni pod parla con ogni altro pod, il token del service account viene montato ovunque, e chi ha accesso al namespace di sviluppo può spesso leggere i Secret di produzione. Nessuna di queste cose è un bug — sono i default del progetto, pensati per far partire le cose in fretta.
Il problema è che questi default restano in produzione per anni. In aula lo verifichiamo con un comando: kubectl auth can-i --list dentro un pod applicativo. Il risultato tipico è una lista di permessi vuota, ma con il token ancora montato e con la rete completamente piatta: enough per esfiltrare dati, non abbastanza per accorgersene.
Questo articolo mette in fila i tre controlli che fanno la differenza — RBAC, Network Policy e gestione dei Secret — seguendo la documentazione ufficiale Kubernetes, che nella versione 1.37 dedica pagine specifiche alle buone pratiche di ognuno.
Il punto di partenza: tre domande diverse
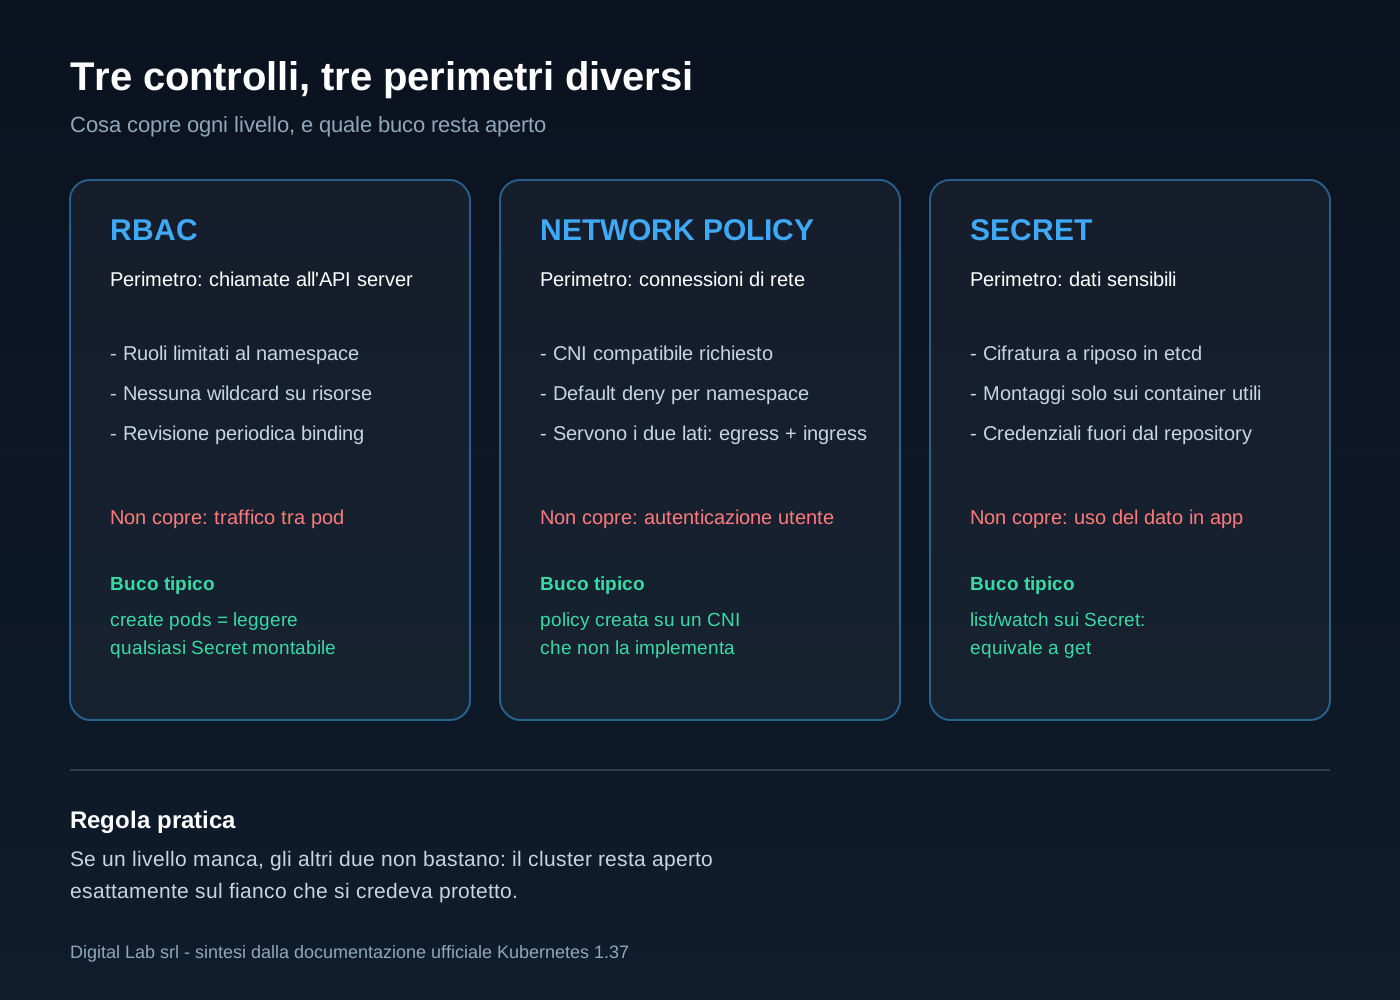
Chi entra, dove può andare, cosa può leggere. Sono tre problemi separati e vanno risolti con strumenti separati, perché ognuno ha i suoi buchi:
- RBAC risponde a chi può chiamare l'API server e con quali verbi. Non protegge il traffico tra pod.
- Network Policy risponde a dove può andare il traffico di rete. Ignora completamente l'autenticazione.
- Secret risponde a cosa può essere letto da un workload. È inutile se i permessi API sono larghi: chi può creare un pod che monta un Secret, di fatto, legge quel Secret.
Confondere i tre livelli è l'errore più comune. Un esempio su tutti: un team blocca con cura l'accesso ai Secret via RBAC, poi lascia create pods in un namespace condiviso. Basta un pod con spec.volumes che punta al Secret per leggerlo, senza mai toccare l'oggetto Secret.
RBAC: il minimo privilegio è un lavoro di sottrazione
La documentazione ufficiale sulle buone pratiche RBAC è più concreta di quanto ci si aspetti. Alcune indicazioni che vale la pena applicare alla lettera:
Preferisci i binding namespaced. Un RoleBinding a un Role limita i permessi a un namespace; un ClusterRoleBinding li estende a tutto il cluster. Nove volte su dieci serve il primo, e nel codice lo si scrive per abitudine al secondo.
Evita le wildcard. Un resources: ["*"] non vale solo per i tipi che esistono oggi: Kubernetes è estensibile, quindi abilita anche tutti i CRD che verranno installati domani. Lo stesso vale per verbs: ["*"], che include escalate e bind.
Non usare cluster-admin per lavorare. Meglio un account a bassi privilegi con diritto di impersonificazione (impersonate), così le modifiche sono un atto deliberato e tracciato, non un effetto collaterale di un kubectl apply distratto.
Non aggiungere nessuno al gruppo system:masters. I membri di questo gruppo bypassano ogni controllo RBAC e anche gli eventuali webhook di autorizzazione: rimuovere il binding non revoca i loro diritti, perché non ne hanno bisogno.
I permessi che valgono più di quanto sembri
La parte più utile del documento è l'elenco dei rischi di escalation. Non sono teorie: sono cose che si trovano nei cluster reali.
| Permesso apparentemente innocuo | Cosa consente davvero |
|---|---|
list o watch su Secret |
Restituisce il contenuto dei Secret, esattamente come get |
create su Pod o workload |
Montare Secret, ConfigMap e volumi, e usare qualsiasi service account del namespace |
create su PersistentVolume |
Creare volumi hostPath, quindi accedere al filesystem del nodo |
get su nodes/proxy |
Chiamare l'API del kubelet, quindi eseguire comandi nei pod, senza audit log |
create su serviceaccounts/token |
Emettere token per service account esistenti |
patch su Namespace |
Cambiare le label del namespace, quindi allargare le policy di rete o di Pod Security |
bind, escalate, impersonate |
Superare i limiti RBAC progettati per impedire l'escalation |
Il caso nodes/proxy merita una nota: sembra un permesso di lettura, perché si esercita con una GET, ma attraverso il kubelet arriva all'esecuzione di comandi nei container. Se un ruolo contiene nodes/proxy, va trattato come un permesso di amministrazione.
Il controllo periodico
RBAC non è un'attività una tantum. Il documento insiste sulla revisione periodica per due motivi pratici: i binding si accumulano durante le emergenze e non vengono mai rimossi, e un utente ricreato con lo stesso nome dopo una cancellazione eredita i permessi del precedente. Un comando utile per l'inventario:
kubectl get clusterrolebindings,rolebindings -A \
  -o custom-columns='TIPO:.kind,NOME:.metadata.name,SOGGETTO:.subjects[*].name,RUOLO:.roleRef.name'
Se tra i soggetti compaiono system:unauthenticated o gruppi che nessuno riconosce, quella è la prima cosa da sistemare.
Network Policy: la rete piatta è un default, non una scelta
Su Kubernetes, per definizione, un pod non è isolato: tutto il traffico in ingresso e in uscita è permesso finché nessuna NetworkPolicy lo seleziona. Un cluster senza policy è una rete a maglia completa dove un container compromesso raggiunge il database, la cache, l'API server e i servizi di osservabilità senza ostacoli. È lo stesso movimento laterale che si combatte in rete con la segmentazione, solo dentro il cluster.
Tre cose da sapere prima di scrivere la prima policy, tutte dalla documentazione sulle Network Policy:
- Serve un CNI che le implementi. Creare un oggetto NetworkPolicy su un plugin che non le supporta non produce alcun effetto e nessun errore. Calico, Cilium, Antrea e Kube-router le supportano; altre soluzioni no.
- Si sommano, non si sovrascrivono. Se più policy si applicano allo stesso pod, il traffico permesso è l'unione di tutte. Non esiste un ordine di valutazione, e non esiste una regola di deny esplicita: il modello è "nega tutto, poi aggiungi allow".
- Servono entrambi i lati. Per far passare una connessione, la policy in uscita sulla sorgente e quella in ingresso sulla destinazione devono permetterla. Mettere in sicurezza solo l'ingresso lascia il cluster aperto verso l'esterno.
Il punto di partenza standard è una policy di default-deny per namespace, che non blocca nulla di specifico ma toglie l'implicitamente permesso:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: produzione
spec:
  podSelector: {}
  policyTypes:
    - Ingress
Da lì si aggiungono regole mirate, per esempio lasciando entrare solo i pod con label app=frontend sulla porta 8080 del backend. Attenzione a un dettaglio che rompe i deploy: quando si abilita il default-deny in uscita, va aperto il DNS verso kube-system, altrimenti la risoluzione dei nomi smette di funzionare.
Quello che Network Policy non fa
Conoscere i limiti evita di comprare un falso senso di sicurezza:
- non gestisce nulla a livello TLS né di livello 7: per questo servono ingress controller o service mesh;
- non può bloccare il traffico da
localhostné quello proveniente dal nodo stesso; - non registra gli eventi di rete bloccati: il logging dipende dal CNI, non dall'API;
- non ha regole di deny esplicite: si possono solo aggiungere permessi a un default chiuso;
- non si applica in modo affidabile ai pod con
hostNetwork: true.
Se l'esigenza è filtrare per dominio o per identità del servizio, NetworkPolicy non è lo strumento: serve un livello sopra.
Secret: base64 non è cifratura
Il punto che sorprende sempre in aula: i Secret, di default, sono salvati in chiaro in etcd, con i valori codificati in base64. La codifica non aggiunge riservatezza, è solo un formato di trasporto. La guida ufficiale sui Secret lo dice senza giri di parole.
Le contromisure, in ordine di impatto:
Cifratura a riposo in etcd. EncryptionConfiguration con un provider di chiavi (KMS consigliato). Senza questo passaggio, chi accede al filesystem di etcd legge tutto, comprese le chiavi di firma del cluster.
RBAC stretto sui Secret. list e watch vanno riservati ai componenti di sistema che ne hanno necessità; per le persone, solo get quando serve davvero. Un alert sull'evento "un singolo soggetto legge molti Secret in poco tempo" intercetta l'esfiltrazione in corso, non quella già avvenuta.
Namespace separati per team. Le buone pratiche di Secret rimandano esplicitamente all'isolamento per namespace: è il confine più semplice e più efficace per limitare l'impatto di un montaggio indesiderato.
Montaggi mirati. Se un pod ha tre container e solo uno deve vedere una credenziale, il volume va montato solo in quel container. Il resto del pod non deve poterla leggere.
Mai nel repository. Un manifest con data: in base64 committato su Git equivale a pubblicare la password. Per questo esistono External Secrets, il Secrets Store CSI Driver e i gestori di segreti dei provider cloud: la credenziale resta fuori dal cluster e viene montata a runtime.
E poi c'è l'ultimo miglio, che nessuna configurazione risolve: l'applicazione non deve scrivere il segreto nei log, non deve rimandarlo in chiaro verso servizi terzi e non deve esporlo in un endpoint di debug. Lo stesso documento ribadisce che il lavoro del cluster finisce dove inizia quello del codice.
Le cinque cose da fare lunedì mattina
Non serve un progetto di rifacimento. Serve un ordine:
automountServiceAccountToken: falsesui workload che non chiamano l'API server. Riduce il numero di token in circolazione senza toccare l'applicazione.- Inventario dei binding RBAC, con rimozione di
cluster-admin, wildcard e soggetti sconosciuti. - Default-deny per namespace in ingresso e, dove possibile, in uscita — con apertura del DNS.
- Cifratura a riposo di etcd, con verifica che il Secret di test appena creato sia davvero cifrato nel file di etcd.
- Revisione dei Secret montati: ogni credenziale deve avere un proprietario, una scadenza e un percorso di rotazione.
In un cluster di medie dimensioni sono due o tre giorni di lavoro, distribuiti. Il ritorno si misura sul tempo di contenimento quando — non se — un pod viene compromesso: la differenza tra un incidente limitato a un namespace e un incidente su tutta l'infrastruttura è quasi sempre in queste cinque righe di configurazione.
Se il team gestisce cluster in produzione ma non ha mai fatto un esercizio di escalation in un ambiente di prova, il modo più efficace di fissare questi concetti è un laboratorio guidato: si parte da un cluster permissivo e si applicano i controlli uno per uno, misurando cosa cambia a ogni passo. È il taglio dei percorsi DevSecOps e Kubernetes di Digital Lab srl, dove la parte su RBAC, isolamento di rete e gestione delle credenziali occupa la maggior parte delle ore.