GitOps e DevSecOps: come rendere tracciabili e sicuri i deployment
Chiedete a un team chi ha fatto l'ultimo deploy in produzione. Se la risposta richiede di aprire una chat, cercare un messaggio di tre settimane fa e chiedere conferma a due persone, il problema non è la tecnologia: è che il deployment non ha una traccia. Il codice in produzione esiste, ma la storia di come ci è arrivato no.
GitOps nasce esattamente per colmare questo vuoto, e la sua definizione non è un'opinione: le GitOps Principles v1.0.0 pubblicate su OpenGitOps ne fissano quattro, e vale la pena leggerle come requisiti tecnici, non come slogan.
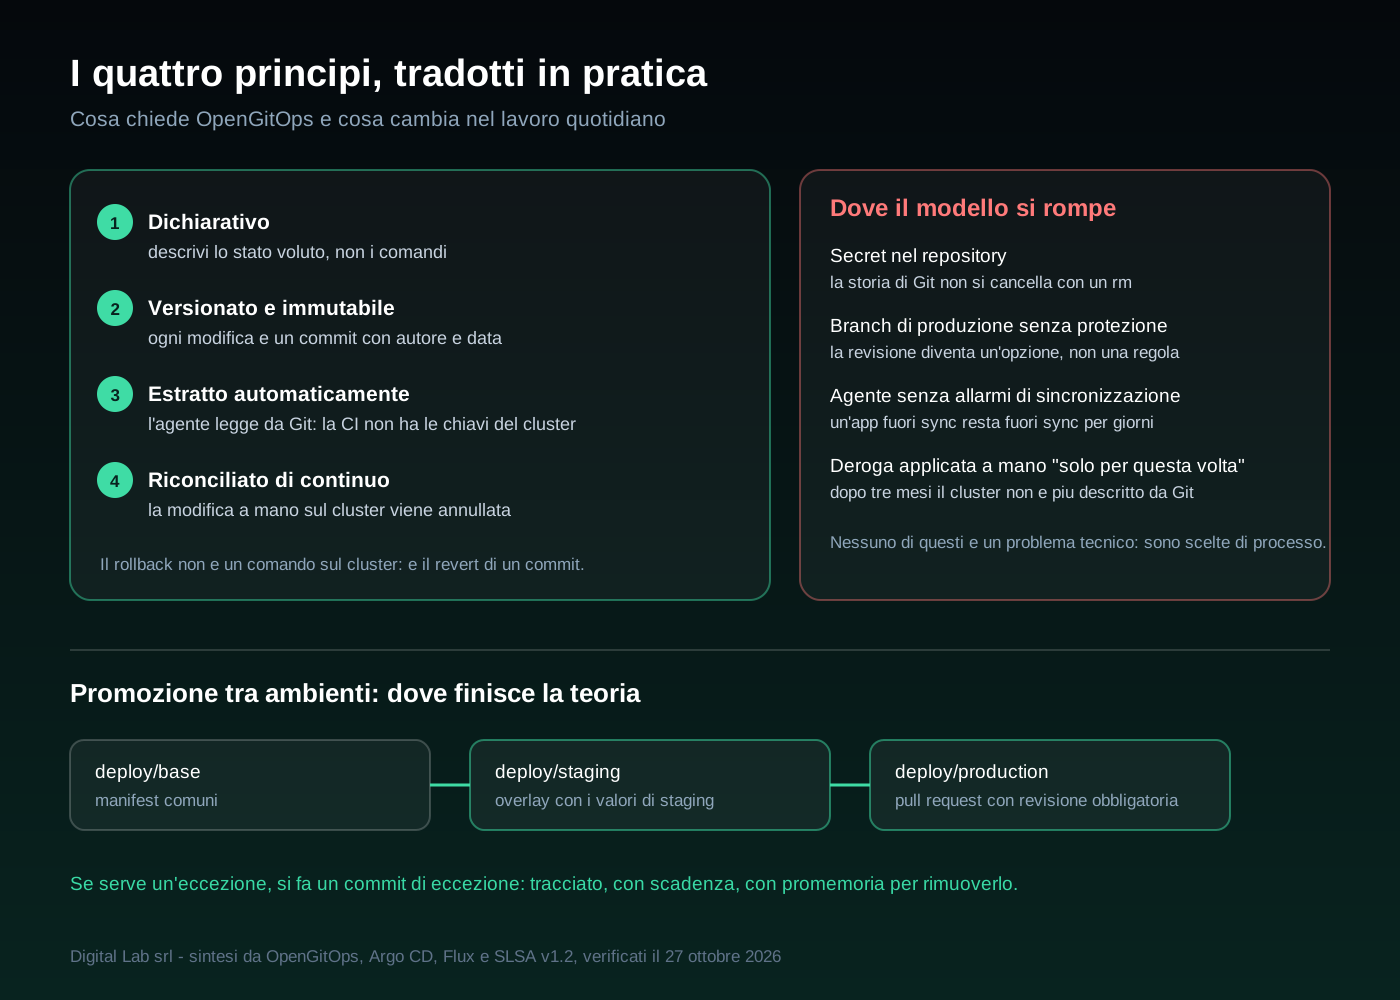
I quattro principi, tradotti in pratica
1. Dichiarativo. Lo stato desiderato del sistema va espresso in modo dichiarativo. Non «esegui questo script che crea tre risorse», ma «il sistema deve trovarsi in questo stato». La differenza si vede nei rollback: uno script eseguito due volte può produrre un risultato diverso, un file di stato applicato due volte no.
2. Versionato e immutabile. Lo stato vive in un repository con storia completa. In pratica: ogni modifica è un commit con autore, data e messaggio, e risalire alla versione in produzione è un git log, non un'archeologia.
3. Estratto automaticamente. Sono gli agenti a leggere lo stato desiderato dal repository. Questo è il punto che distingue GitOps da un CI che lancia kubectl apply: nel modello pull il cluster va a prendersi la configurazione, quindi la pipeline non ha bisogno delle credenziali del cluster. Se il runner CI è compromesso, non può parlare direttamente con la produzione.
4. Riconciliato continuamente. Un agente osserva lo stato reale e prova ad allinearlo a quello desiderato. Non è un dettaglio: è ciò che trasforma Git da «registro delle intenzioni» a fonte di verità, perché una modifica fatta a mano sul cluster viene rilevata e annullata.
Su questi principi si appoggiano i due strumenti più diffusi: Argo CD, che si descrive come «declarative GitOps continuous delivery tool for Kubernetes», e Flux, che gestisce applicazioni e infrastruttura con riconciliazione automatica e supporta anche Kustomize e Helm.
Il pull cambia il modello di rischio
La differenza tra push e pull non è stilistica. In un pipeline che fa push, il sistema di CI/CD possiede credenziali con privilegi sul cluster: chi controlla la pipeline controlla l'infrastruttura. In un modello pull, il CI produce un artefatto e aggiorna un riferimento in Git; l'agente nel cluster legge. Le credenziali restano dove servono, e il CI diventa un bersaglio meno interessante.
C'è un secondo effetto, spesso sottovalutato: il repository diventa il punto di controllo degli accessi. Se il branch protetto richiede una pull request con revisione, allora ogni cambiamento in produzione passa da una revisione. Non serve un processo separato: la piattaforma di versionamento lo impone da sola.
Attenzione però a non confondere le due cose. Il fatto che una modifica sia in Git non la rende sicura: rende sicuro il percorso con cui arriva. Un secret in chiaro in un repository versionato resta un incidente, indipendentemente da quanto sia elegante il flusso.
Segreti: l'unica cosa che non va in Git
Se lo stato desiderato vive in Git, la tentazione è metterci tutto. I segreti no, e la regola vale anche per i repository privati: un repository Git è un archivio distribuito, la cui storia non si cancella con un git rm.
Le opzioni pratiche sono tre:
- segreti esterni recuperati a runtime da un gestore (Vault, Secrets Manager, Key Vault) tramite operator o CSI driver: il repository contiene un riferimento, non il valore;
- cifratura nel repository con chiavi gestite fuori: il file cifrato è versionabile, la chiave no;
- secret generati dagli operator a partire da credenziali di piattaforma, quando il servizio lo consente.
Qualunque strada si scelga, la rotazione deve essere possibile senza riscrivere la storia del repository. Se ruotare un segreto richiede un commit di emergenza sul branch protetto, il processo verrà aggirato alla prima urgenza.
I gate di sicurezza nella pipeline
Qui GitOps e DevSecOps si incontrano: se ogni modifica passa da una pull request, la pipeline può verificare molto prima che il cambiamento arrivi al cluster. I controlli che danno il miglior rapporto tra costo e beneficio sono quattro:
Scansione dell'infrastruttura come codice. Un manifest che apre una porta al mondo o monta un volume con privilegi elevati va intercettato prima del merge. È lo stesso principio che vale per Terraform, dove il rischio sta nel piano di esecuzione più che nel codice.
Scansione delle immagini e inventario dei componenti. Un'immagine senza SBOM è una scatola nera: quando esce una vulnerabilità, non si sa quali servizi la contengono. Il controllo va fatto sui tag immutabili (digest), non sui tag mobili come latest.
Provenienza e livelli di supply chain. SLSA, nella versione 1.2 della specifica, organizza le garanzie in livelli: la build track va da L0 («nessuna garanzia») a L1 («esiste una provenienza»), L2 («provenienza firmata generata da una piattaforma di build ospitata») e L3 («piattaforma di build rafforzata»). Anche solo arrivare a L2 con attestazioni verificate elimina un'intera classe di attacchi: la sostituzione dell'artefatto dopo la build.
Policy di ammissione nel cluster. Le regole di sicurezza applicate all'ingresso (niente container privilegiati, niente immagini da registry non ammessi, risorse con limiti obbligatori) sono l'ultimo filtro prima dell'esecuzione. Vanno scritte una volta e non duplicate in ogni pipeline.
Un dettaglio organizzativo che vale più di qualsiasi scanner: chi approva il merge non deve essere la stessa persona che ha accesso amministrativo al cluster. La separazione dei compiti è ciò che rende la revisione una revisione e non una formalità.
La promozione tra ambienti
Il punto in cui molti progetti GitOps si fermano è la promozione: funziona in staging, ma in produzione si applica «a mano» perché c'è fretta. Il risultato è che la produzione non è più descritta dal repository, e la riconciliazione continua diventa un fastidio da disattivare.
La struttura che regge è banale e va difesa:
deploy/
  base/            # manifest comuni
  staging/         # overlay con i valori di staging
  production/      # overlay con i valori di produzione
La promozione è una pull request che modifica l'overlay di produzione, con revisione obbligatoria. Se serve un'eccezione, si fa un commit di eccezione — tracciato, con una data di scadenza e un promemoria per rimuoverla. Quello che non si fa è intervenire direttamente sul cluster: se succede, la riconciliazione lo annullerà comunque, restituendo il sistema allo stato di Git. È il comportamento corretto, ma va spiegato a chi lo scopre alle tre di notte.
Un caso che semplifica molte discussioni: il rollback. In GitOps non si «rolla indietro nel cluster», si fa il revert del commit. Il risultato è lo stesso, la differenza è che resta la traccia di chi ha annullato cosa e perché.
Gli errori che tornano sempre
- Repository unico per tutto, con ambienti diversi gestiti da cartelle e una pipeline che indovina il contesto. Funziona finché non serve un permesso differenziato.
- Branch di produzione senza protezione. Il giorno in cui qualcuno pusha direttamente, la revisione diventa un'opzione.
- Agente installato e dimenticato. Senza allarmi sullo stato di sincronizzazione, un'applicazione può restare fuori sync per giorni senza che nessuno lo sappia.
- Drift tollerato. La modifica manuale «solo per questa volta» è l'inizio della fine: dopo tre mesi il cluster contiene cose che il repository non descrive.
- Segreti in Git con la giustificazione che il repository è privato.
Nessuno di questi errori è tecnico. Sono scelte di processo che la tecnologia rende visibili, ed è esattamente il motivo per cui GitOps funziona quando c'è un accordo di squadra, e non funziona quando si prova a imporlo come strumento.
Da dove iniziare
Per un team che parte da zero, la sequenza più breve che porta a un risultato verificabile:
- un repository per gli ambienti, con
basee un overlay per staging; - un agente che riconcilia solo staging, con allarme sullo stato di sincronizzazione;
- protezione del branch e revisione obbligatoria, anche quando c'è una sola persona nel team;
- scansione di immagini e manifest nella pipeline, che blocca il merge e non solo avvisa;
- produzione solo dopo che i primi quattro punti hanno funzionato per due settimane.
Il passo 3 è quello che tutti rimandano ed è quello che determina se il resto ha senso.
Se il team gestisce già cluster Kubernetes e vuole portare la parte di sicurezza dentro il flusso di deployment, il percorso DevSecOps, Kubernetes e container di Digital Lab srl lavora su questo: pipeline con gate reali, gestione dei segreti fuori dal repository e riconciliazione continua, con laboratori su cluster veri.
Per chi vuole approfondire i due lati del problema, sul sito ci sono anche Terraform e Infrastructure as Code: vantaggi, rischi e controlli di sicurezza e Sicurezza dei container: 12 errori da evitare prima del deployment.