AI-native SDLC: come cambia il processo di sviluppo quando il codice non è più il collo di bottiglia
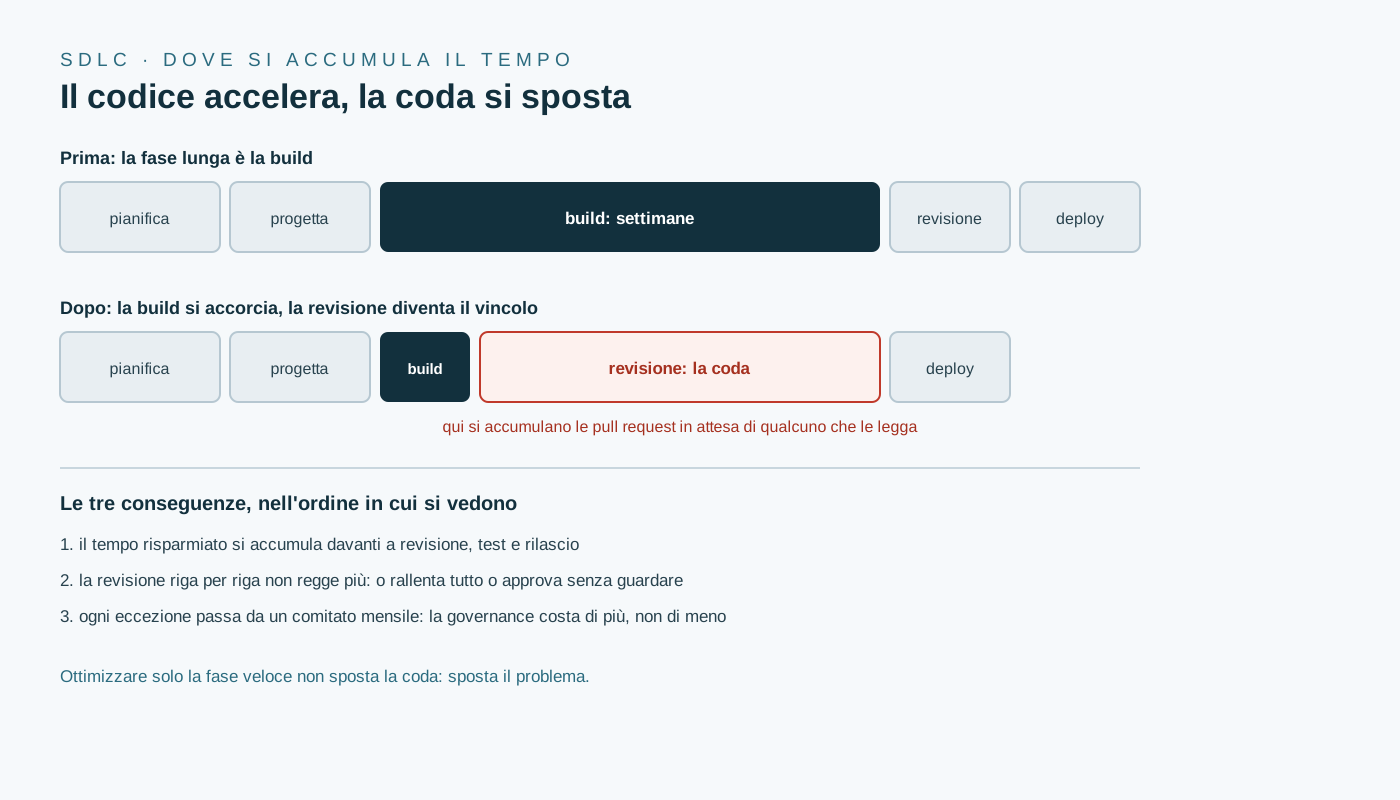
Un team adotta un agente di coding. In due settimane il tempo medio per aprire una pull request crolla: quello che prima richiedeva tre giorni ora richiede tre ore. Dopo un mese le PR in attesa di revisione sono quaranta, i revisori leggono di fretta, e il rilascio in produzione è ancora ogni due settimane. Ogni singolo passo è diventato più veloce, il flusso complessivo no.
È il punto di partenza del The AI-Native SDLC playbook pubblicato da Anthropic il 21 agosto 2026: un documento lungo, molto operativo, che prova a riscrivere il processo di sviluppo attorno a un'ipotesi scomoda, cioè che il collo di bottiglia si sia spostato fuori dalla scrittura del codice.
La diagnosi: tre effetti in contemporanea
Quando il codice smette di essere la fase lenta, secondo il playbook succedono tre cose insieme.
Il collo di bottiglia si sposta ai due lati. Progettazione, revisione, test e rilascio continuano a girare a velocità umana. Il tempo risparmiato sulla scrittura si accumula in coda altrove.
I controlli non corrispondono più alla realtà. Leggere ogni riga ha senso quando quelle righe le ha scritte una persona. Se l'agente produce la maggior parte del diff, la revisione riga per riga non regge: o si rallenta tutto, o si approva senza guardare.
La governance costa di più. Le eccezioni passano ancora da comitati che si riuniscono una volta al mese, e ogni eccezione in più allunga la fila.
La conclusione del documento è che non basta ottimizzare il pezzo veloce: serve ripensare il processo che lo circonda. Chi ha studiato la storia dell'industria conosce già l'analogia giusta — le prime fabbriche elettrificate misero il motore elettrico dove prima c'era la macchina a vapore, ottenendo per anni gli stessi risultati; il salto arrivò quando l'impianto fu ridisegnato intorno all'elettricità.
Da flusso lineare a ciclo di artefatti
La proposta del playbook non tocca le sei fasi classiche — pianificazione, progettazione, build, test, deploy, manutenzione — ma il modo in cui si passano il lavoro. Invece di passaggi di consegna fatti di riunioni, ticket e firme, ogni fase chiude committando un file e la successiva inizia leggendolo:
intent.md → spec.md → plan.md → codice e test → PR con i risultati della revisione → record dell'incidente → nuovo intent.md.
Il dettaglio che rende il meccanismo interessante è che lo stesso file viene letto da una persona e da un agente. Un responsabile di prodotto può lavorare su intent.md; un modello può fare lo stesso, e produrre lo spec.md che ne deriva. I documenti smettono di essere promemoria per umani e diventano l'interfaccia tra umani e agenti.
C'è un effetto collaterale che vale da solo il prezzo del biglietto: la catena di commit è anche la traccia di audit. Chi ha chiesto cosa, cosa ha prodotto l'agente, chi ha approvato, quando. In un'azienda regolata questa è la parte che di solito manca, e che di solito costa mesi di lavoro a posteriori.
Il playbook organizza il resto in sedici play distribuiti sulle sei fasi, ognuno con la stessa struttura: cosa cambia, da dove iniziare, i passi concreti, la governance e come misurarlo. È un formato da manuale, non da manifesto, e questo dice molto sull'intenzione.
Il piano al posto del codice
La parte più controversa è probabilmente la fase di build: gli ingegneri aprono la sessione in modalità piano, danno all'agente lo spec.md approvato e discutono il piano di implementazione — quali file cambiano, in che ordine, cosa può rompersi, come si dimostra che è finito — prima che venga scritta una riga.
La misura di qualità del piano è brutale e utile: un ingegnere che non ha partecipato alla discussione deve poter implementare la modifica partendo solo dal piano. Se non è così, il piano è ancora una bozza.
Il vantaggio è dove si sposta la revisione. Discutere un piano costa minuti; scoprire che il diff ha preso la strada sbagliata costa giorni. Ma attenzione: questo funziona solo se qualcuno quel piano lo legge davvero. Un piano approvato con un pollice in su dopo quindici secondi è la versione nuova della firma a cascata.
Tre file che fanno il lavoro sporco
Il playbook insiste su tre artefatti che non sono burocrazia, e che si possono introdurre anche senza adottare il resto.
CLAUDE.md: il manuale per il nuovo arrivato — comandi di build, test e lint, convenzioni, architettura, errori ricorrenti. Deve stare sotto una pagina, perché l'agente lo rilegge a ogni sessione e tutto ciò che è obsoleto occupa contesto senza produrre nulla. Regola operativa: un errore che si ripete due volte finisce nel file.
Skills: conoscenza istituzionale resa operativa. Standard di sicurezza, regole di brand, convenzioni API scritte come istruzioni versionate, con un proprietario della policy che le firma. Sono un controllo consultivo: rendono probabile il rispetto della regola.
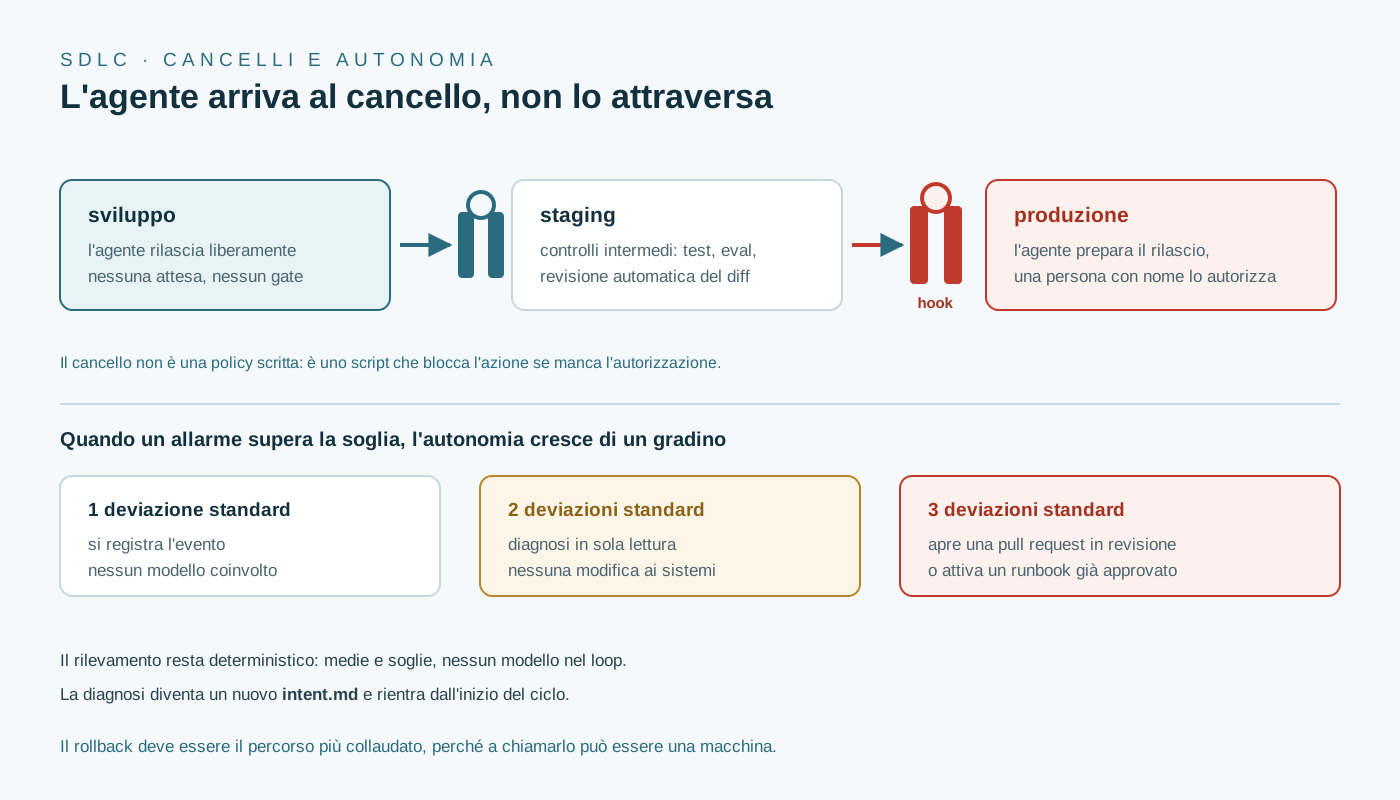
Hooks: la parte deterministica. Sono script che girano prima o dopo un'azione dell'agente e possono consentirla, bloccarla o chiedere un'approvazione. Nella documentazione di Claude Code un hook PreToolUse può negare un comando di shell; nel playbook questo diventa il cancello di produzione: nessun deploy senza un'autorizzazione nominata, e la regola vale per tutti, sempre.
La sintesi che vale la pena ricordare è che le skill rendono la violazione improbabile, gli hook la rendono quasi impossibile. Chi ha provato a far rispettare una policy solo con un documento sa quanto costa la differenza.
Il test che l'agente non può riscrivere
La fase di test contiene l'idea più elegante del documento. Per correggere un bug, l'agente deve prima riprodurlo come test che fallisce, committare quel test, e solo dopo correggere il codice — con un hook che gli impedisce di modificare il file di test durante il lavoro.
Il motivo è semplice: un agente che può aggiustare il test può far passare qualsiasi cosa. Un test scritto prima della correzione, e che l'agente non ha il permesso di toccare, è la prova che il difetto è sparito davvero.
Lo stesso principio si applica alla configurazione dell'agente: CLAUDE.md, skill e hook vengono testati come codice. La ricetta proposta è concreta — 20-50 task reali presi dal lavoro recente, con esito atteso, rieseguiti a ogni modifica della configurazione, e un nuovo caso per ogni incidente in produzione. È il modo per accorgersi che una modifica alle istruzioni ha peggiorato il comportamento prima che lo faccia in produzione.
Il ciclo che si chiude, e chi tiene le chiavi
Nella fase di manutenzione il playbook fa un salto: l'agente non viene invocato da una persona ma da uno script. Il monitoraggio resta deterministico — medie e deviazioni standard su una finestra mobile, nessun modello coinvolto — e l'agente si sveglia solo quando una soglia viene superata.
L'autonomia cresce con la gravità: a una deviazione standard si registra l'evento, a due l'agente diagnostica in sola lettura, a tre può agire, ma solo aprendo una PR che passa dalla revisione o attivando un runbook già approvato. La diagnosi viene scritta come un nuovo intent.md e rientra dall'inizio: un problema di produzione diventa il prossimo lavoro di sviluppo, invece di fermarsi in un post-mortem che nessuno rilegge.
Due conseguenze pratiche. La prima: il rollback deve essere il percorso più collaudato della pipeline, perché a chiamarlo può essere una macchina alle tre di notte. La seconda: i permessi contano più delle promesse. Un agente che non ha credenziali di produzione non le usa, indipendentemente da quanto è bravo.
Cosa prenderei, cosa lascerei
Una lettura onesta deve dire che questo è il playbook di un fornitore, pensato per il proprio prodotto, non uno standard approvato da qualcuno. Le etichette circolano già — agentic SDLC, AI SDLC — e la sostanza cambierà. Agile, dal manifesto alla diffusione di massa, ha impiegato quasi dieci anni.
Detto questo, tre cose mi sembrano solide e indipendenti dal vendor:
- Il collo di bottiglia si sposta. Lo si vede già nelle aziende che usano gli agenti: la revisione diventa il vincolo. Questo è vero con qualunque strumento.
- La governance deve stare nell'azione, non nella riunione. Hook e permessi sono verificabili; un comitato mensile no.
- Il ciclo chiuso è un vantaggio reale. Trasformare un incidente in un test e in un intento è ciò che distingue un'organizzazione che impara da una che si limita a sopravvivere.
E una cosa la lascerei: l'idea che si possa partire dai documenti. Il playbook funziona perché presume una base che molte aziende non hanno — test automatici che girano in un comando, un deploy ripetibile, un ambiente di osservabilità, una pipeline che non richiede una persona specifica. Senza quella base, intent.md e plan.md sono due file in più. Le fondamenta sono le stesse di sempre: infrastruttura come codice, come raccontato in Terraform e Infrastructure as Code, configurazione gestita da strumenti come Ansible (qui l'articolo), e rilasci tracciabili con il GitOps.
Un'ultima nota di merito, che riguarda chi scrive: senza un registro dei casi d'uso e dei rischi, l'AI in azienda resta un insieme di iniziative scollegate. Il playbook sposta il problema dal "quale modello" al "quale processo", che è la domanda giusta; ma la cornice di governance serve comunque, e ne abbiamo scritto parlando di AI governance e obblighi normativi.
Cosa fare nei primi trenta giorni
Quattro mosse, nell'ordine in cui le farei.
Scrivere il CLAUDE.md e verificarlo. Comandi, convenzioni, errori ricorrenti; sotto una pagina. Se il file non cambia mai, non lo sta leggendo nessuno.
Mettere un hook e vedere se regge. Uno solo, il più utile: bloccare le modifiche ai file di test nei task di correzione, oppure negare i comandi che toccano la produzione. Un hook che non scatta mai va rimosso, non lasciato lì.
Provare il ciclo bug-test-fix su tre difetti reali. Non su un progetto demo: sui tre bug che aspettano in backlog da più tempo. Se il test scritto prima non fallisce, il metodo non ha funzionato.
Raccogliere venti task e farne una piccola suite. Anche solo venti, anche con controlli semplici. Serve a scoprire quando una modifica alle istruzioni dell'agente peggiora i risultati.
Il resto — le sedici play, il ciclo automatico, il monitoraggio a bande — viene dopo, e solo se la base tiene.
Se il team deve costruire quella base, nei percorsi del catalogo Digital Lab trovate sviluppo, test, pipeline e DevOps con laboratori su progetti reali: sono le competenze che rendono un processo come questo eseguibile, invece che solo leggibile.