Ansible per le operations: come automatizzare configurazioni ripetitive senza perdere il controllo
Un playbook che doveva aggiungere una riga in un file di configurazione viene lanciato tre volte in due settimane. Alla quarta verifica il file ha tre righe quasi identiche, il servizio parte ma con un ordine di priorità che nessuno aveva previsto, e la persona che aveva scritto il playbook nel frattempo ha cambiato progetto. Il problema non è Ansible: è che nessuno si è chiesto che cosa significasse "eseguirlo due volte".
Automatizzare le operations con Ansible è facile da iniziare e difficile da fare bene. La sintassi YAML si impara in un pomeriggio, la prima esecuzione su dieci server sembra magia. Poi arriva l'inventario che invecchia, il playbook che nessuno osa più toccare, il shell: che fa il lavoro di un modulo. Il controllo non si perde per un errore tecnico, si perde perché mancano le quattro o cinque abitudini che rendono un'automazione verificabile.
Perché Ansible è diventato lo standard di fatto
La scelta architetturale è la ragione del successo: Ansible è agentless. Si installa su un solo host, il control node, e da lì gestisce l'intero parco di macchine via SSH, PowerShell remoting e altri trasporti, senza database né demoni da installare sugli host gestiti. Lì serve solo Python e un account con una shell POSIX, con le eccezioni documentate dei moduli di rete, che non richiedono Python sul dispositivo.
Tradotto in pratica: in un'azienda con VMware, apparati Cisco, qualche server Windows e tre cloud, Ansible è l'unico strumento di automazione che si può introdurre senza una migrazione. Non serve un agente su ogni macchina, non serve aprire porte nuove, non serve convincere il team di sicurezza a installare un altro servizio.
Prima di scrivere il primo task: due scelte che pesano
Quale pacchetto installare. Esistono due distribuzioni: ansible-core, il runtime minimale con i moduli e i plugin integrati, e ansible, il pacchetto completo che aggiunge una selezione curata di collection della community. Chi gestisce solo Linux può partire da ansible-core e installare le collection che gli servono; chi deve coprire più vendor trova nel pacchetto completo un punto di partenza più comodo. La documentazione ufficiale descrive le due opzioni e i modi di installazione.
Come riferirsi ai moduli. Dalla versione 2.10 la raccomandazione è usare il nome completo della collection, il FQCN: ansible.builtin.template invece di template. Non è pedanteria: collection diverse possono contenere moduli con lo stesso nome, e un playbook che funziona oggi può cambiare comportamento domani se un modulo omonimo entra in scena.
L'idempotenza non è una proprietà del linguaggio
La documentazione definisce idempotenti i moduli che verificano se lo stato desiderato è già raggiunto e in quel caso non fanno nulla: eseguire il task una o dieci volte non cambia il risultato finale. È la proprietà che rende un playbook un documento di configurazione e non una sequenza di comandi.
Il punto che sfugge è che l'idempotenza la danno i moduli, non YAML. Un ansible.builtin.lineinfile sa se la riga c'è già. Un ansible.builtin.command o uno shell no: eseguono sempre, e se il comando non è scritto per essere ripetibile, il danno si accumula in silenzio. La documentazione stessa avverte che non tutti i moduli e non tutti i playbook si comportano così, e consiglia di provarli in un ambiente di test prima di rieseguirli in produzione.
La regola operativa che ne deriva: command e shell solo quando non esiste un modulo, sempre con creates o changed_when espliciti, e con un commento che spiega perché. Un playbook con venti shell: è un elenco di comandi travestito.
Un esempio minimo ma completo, con la parte che quasi tutti dimenticano — l'handler che ricarica il servizio solo se il file è cambiato:
- name: Configurazione del servizio
  hosts: web
  become: true
  serial: 2
  tasks:
    - name: Template di configurazione
      ansible.builtin.template:
        src: nginx.conf.j2
        dest: /etc/nginx/nginx.conf
        owner: root
        mode: "0644"
        validate: nginx -t -c %s
      notify: Ricarica nginx

  handlers:
    - name: Ricarica nginx
      ansible.builtin.service:
        name: nginx
        state: reloaded
Tre dettagli contano più del resto: validate impedisce di installare un file sintatticamente rotto, notify evita ricariche inutili, serial: 2 non butta giù tutto il cluster in una volta.
Verificare prima di eseguire
Ansible mette a disposizione diversi controlli che costano pochi secondi e risparmiano un incidente.
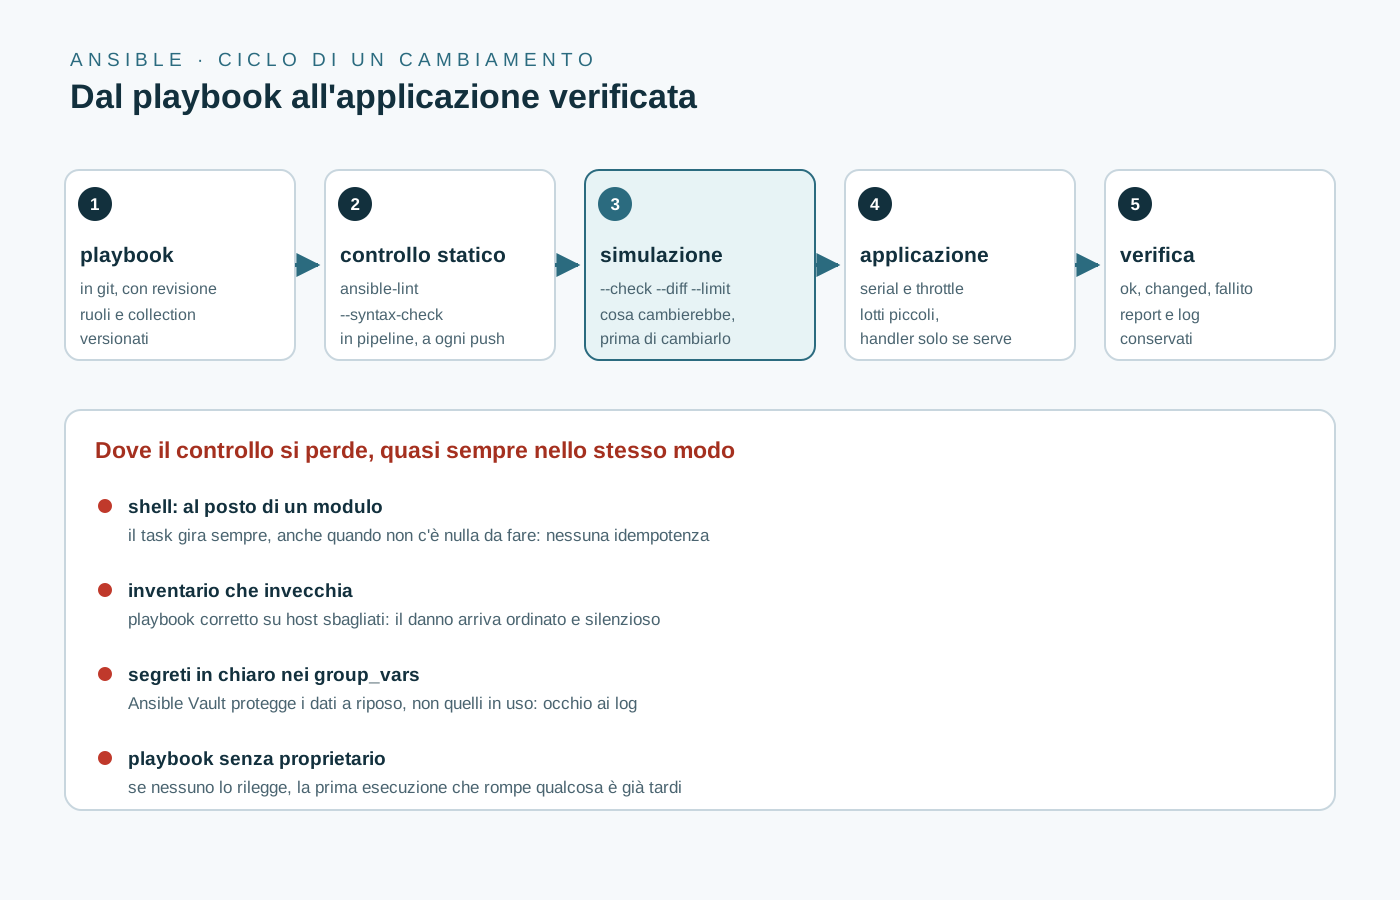
--syntax-checke--list-tasksper capire che cosa il playbook farà davvero, prima di farlo.--checkper eseguire in modalità di sola verifica: Ansible riporta le modifiche che applicherebbe senza applicarle. È lo strumento più utile e il più inaffidabile, perché alcuni moduli non lo supportano e restituiscono risultati parziali: va letto, non preso alla lettera.--diffper vedere il contenuto delle modifiche, non solo il nome del task.ansible-lint, il linter specifico per playbook, ruoli e collection: segnala pratiche note per generare bug o codice difficile da mantenere. È volutamente opinionato, le regole si possono disattivare una per una, e la documentazione raccomanda di usarlo con la versione più recente di Ansible anche se in produzione girate su una più vecchia.
Il salto di qualità è mettere ansible-lint e --syntax-check in pipeline, su ogni push. Un playbook che non passa il linter non arriva in produzione. È la stessa logica del Terraform e Infrastructure as Code: il codice di infrastruttura si tratta come codice, con revisione e controlli automatici.
Eseguire senza spegnere tutto
Il comportamento predefinito è lineare: ogni task gira su tutti gli host del pattern, cinque fork in parallelo, poi si passa al task successivo. Su venti server è la scelta giusta. Su duecento, o su un cluster dove riavviare due nodi insieme significa perdere il servizio, va cambiato.
serial è la direttiva che regola la dimensione dei lotti: un numero, una percentuale o una lista di valori, con la possibilità di partire da un host solo e allargare. throttle limita i worker di un singolo task, utile quando il task chiama un'API che applica rate limit. run_once esegue un task su un solo host del lotto, per esempio una migrazione di schema prima del rilascio.
A questi si aggiunge --limit, che nella pratica è il salvavita di ogni esecuzione: si prova il playbook su un host, poi su un gruppo piccolo, poi su tutti. Chi lancia un playbook nuovo direttamente sul gruppo di produzione non sta automatizzando, sta sperando.
I segreti, il punto in cui il controllo si perde davvero
Ansible Vault cifra variabili e file, così che password e chiavi non restino in chiaro nei playbook o nei repository. Ha però un limite che la documentazione dichiara esplicitamente: protegge i dati a riposo, non i dati in uso. Nel momento in cui il contenuto viene decifrato, sta agli autori dei playbook evitare la fuga, per esempio con no_log sui task che maneggiano credenziali, altrimenti la password finisce nel log dell'esecuzione.
Due conseguenze pratiche. La prima: la password del vault non va nel repository, va in un password manager o in un secret manager, con uno script che la recuperi. La seconda: i log di Ansible possono contenere output di comandi potenzialmente sensibili, quindi la loro conservazione va trattata come quella di qualsiasi altro log applicativo.
L'inventario è la parte che invecchia peggio
Un playbook corretto eseguito su un inventario sbagliato produce un disastro ordinato. Gli inventari statici in INI o YAML vanno bene per laboratori e prime prove; appena il parco macchine cambia, servono plugin dinamici che leggono l'inventario da vCenter, dai cloud provider o dal CMDB.
Tre abitudini limitano il danno: un gruppo per ogni ruolo funzionale e non per reparto, variabili in group_vars e host_vars con una gerarchia dichiarata, e un test periodico che confronta l'inventario con la realtà — un ansible-inventory --list contro quello che i sistemi di monitoraggio vedono. La differenza tra i due elenchi è il lavoro che nessuno ha ancora fatto.
Dove Ansible non è lo strumento giusto
Ci sono casi in cui automatizzare è peggio che fare a mano. I cambi su database che richiedono finestre di manutenzione e verifiche applicative, le modifiche su apparati con configurazioni fragili e poco documentate, gli interventi in emergenza durante un incidente: in tutti questi casi il playbook diventa un modo per rendere più veloce un errore.
Il criterio è semplice: se il cambiamento non è ripetibile in modo sicuro, non è ancora il momento di scriverlo in YAML. Si scrive la procedura, si esegue due o tre volte a mano, si documenta cosa può andare storto. Solo dopo diventa un ruolo.
Vale anche il contrario: se la stessa modifica viene fatta a mano più di due volte al mese, ogni giorno in più è tempo speso male. Un script Python ben fatto risolve il caso singolo, Ansible risolve il caso ripetuto su molti host, e la scelta tra i due dipende da quante macchine e quante varianti avete.
Le competenze che fanno la differenza
Nella pratica la difficoltà non è la sintassi. È saper leggere un output, distinguere changed da ok, riconoscere un task che finge di essere idempotente, progettare un inventario che regga due anni, decidere quando un serial è troppo piccolo e quando è teatro. Sono competenze da sistemista e da chi conosce i sistemi che sta configurando: nessun playbook generico le sostituisce.
Se il team deve costruire questa base — automazione delle configurazioni, gestione dei segreti, integrazione in pipeline con revisione e controlli — nel catalogo dei corsi Digital Lab trovate i percorsi su DevOps, infrastructure as code e operations, con laboratori su ambienti reali.