Python per l'automazione IT: 5 casi d'uso utili per sistemisti e network engineer
Chi amministra sistemi e reti ha un rapporto complicato con l'automazione: la riconosce come necessaria, la rimanda perché «serve un programmatore» e nel frattempo continua a fare le stesse venti operazioni a mano, una volta a settimana, per anni. Eppure gli strumenti per iniziare sono pochi e non richiedono una laurea in informatica: un interprete, la libreria standard e, quando serve, un paio di librerie specifiche.
La soglia vera non è la sintassi. È capire quali attività vale la pena automatizzare: chi parte da un progetto ambizioso — orchestrare l'intera rete — di solito si blocca alla terza settimana. Chi parte da un compito noioso, ripetitivo e verificabile ottiene un risultato in un pomeriggio, e da lì non torna indietro.
Cinque casi d'uso, in ordine crescente di difficoltà. Il codice è volutamente breve: serve a mostrare la forma, non a essere copiato.
1. Backup delle configurazioni di rete
È il caso d'uso con il miglior rapporto tra sforzo e risultato, e anche il più facile da difendere davanti a un responsabile: senza backup delle configurazioni, ogni cambio sbagliato diventa un'ora di ricostruzione a memoria.
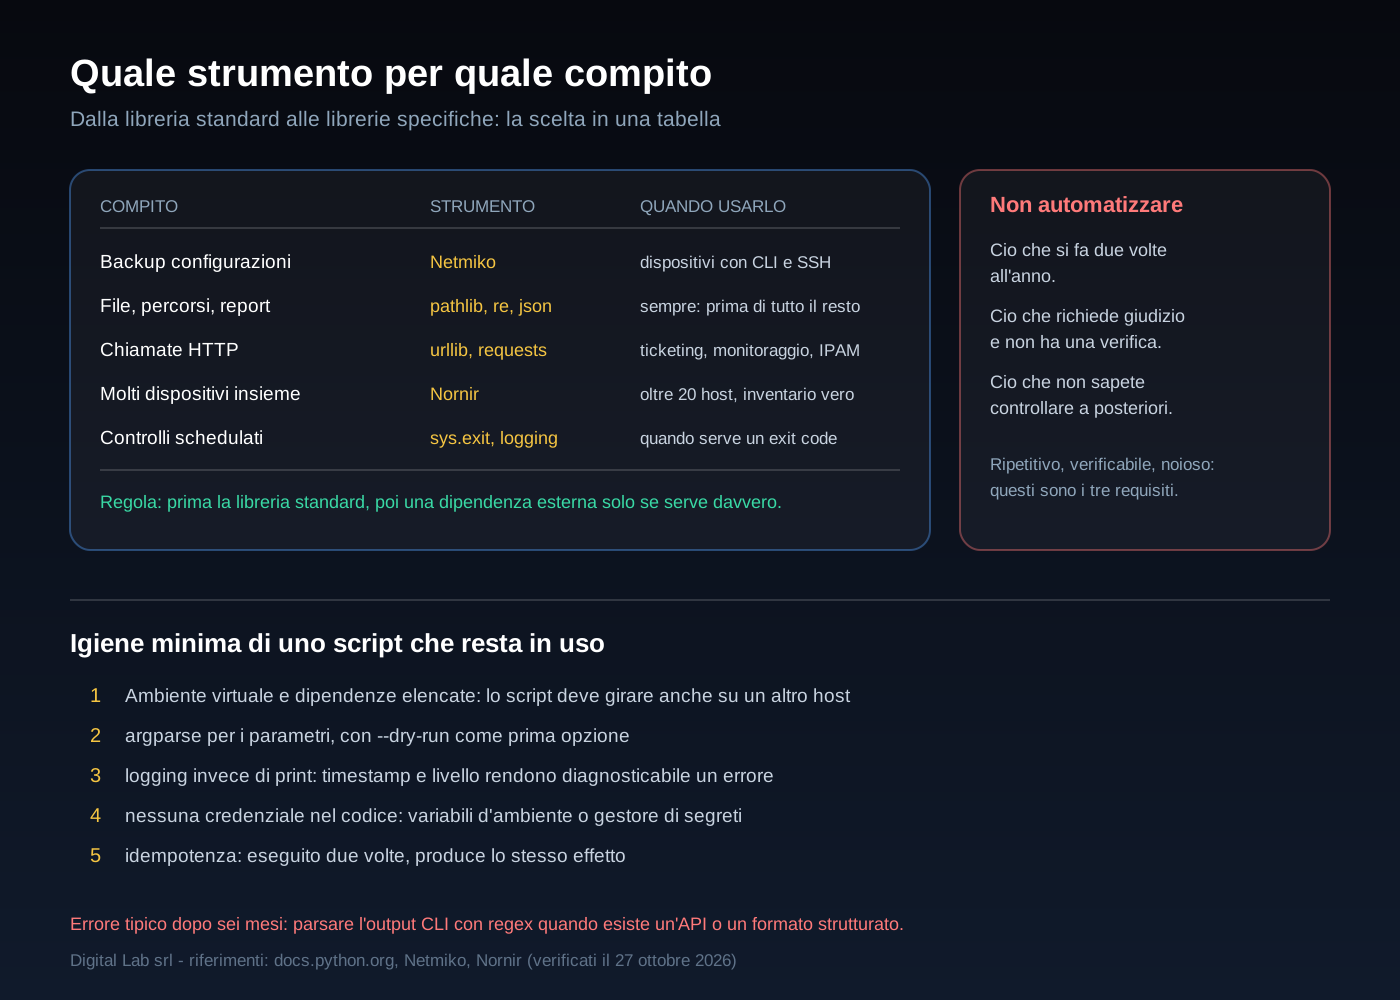
Con Netmiko, che si presenta come libreria multi-vendor per semplificare le connessioni SSH ai dispositivi di rete, il ciclo è: leggi l'inventario, connettiti, esegui il comando, salva il risultato con la data nel nome del file.
from pathlib import Path
from datetime import date
from netmiko import ConnectHandler

DISPOSITIVI = [
    {"device_type": "cisco_ios", "host": "10.0.0.1", "username": "svc-automation", "password": "..."},
    {"device_type": "cisco_ios", "host": "10.0.0.2", "username": "svc-automation", "password": "..."},
]

destinazione = Path("backup") / date.today().isoformat()
destinazione.mkdir(parents=True, exist_ok=True)

for d in DISPOSITIVI:
    with ConnectHandler(**d) as conn:
        config = conn.send_command("show running-config")
    (destinazione / f"{d['host']}.cfg").write_text(config, encoding="utf-8")
Due dettagli che fanno la differenza in produzione: l'utente usato per l'automazione deve avere un ruolo dedicato in sola lettura, e i backup devono finire in un posto versionato o almeno immutabile — un backup che si può sovrascrivere non è un backup.
2. Inventario e report da file esistenti
Prima di automatizzare qualcosa bisogna sapere cosa c'è. Nella maggior parte delle reti questa informazione esiste già, sparsa tra file di configurazione, export CSV e documenti aggiornati a mano. pathlib della libreria standard, la cui documentazione è su docs.python.org, gestisce percorsi e file in modo portabile: niente più os.path.join sparsi e script che funzionano solo su Linux.
from pathlib import Path
import re

righe = []
for cfg in Path("backup").rglob("*.cfg"):
    testo = cfg.read_text(encoding="utf-8", errors="replace")
    hostname = re.search(r"^hostname (\S+)", testo, re.M)
    modello = re.search(r"^! device: (\S+)", testo, re.M)
    righe.append((hostname.group(1) if hostname else "?", modello.group(1) if modello else "?"))

for host, modello in sorted(righe):
    print(f"{host:30} {modello}")
Il valore non è nello script: è nel fatto che l'output diventa un dato confrontabile. Da qui si arriva in un passo al controllo di conformità — «quali dispositivi non hanno service password-encryption?» — che è il punto di partenza di qualsiasi discorso serio su hardening.
3. Chiamate alle API degli strumenti che già usate
Il sistema di ticketing, il monitoraggio, l'IPAM, il controller wireless: quasi tutti espongono un'API. Spesso il lavoro manuale consiste proprio nel copiare dati da un'interfaccia all'altra, ed è il tipo di attività in cui un errore di battitura costa mezz'ora di diagnosi.
import json
import urllib.request

def api(url, token, payload=None):
    dati = json.dumps(payload).encode() if payload else None
    req = urllib.request.Request(url, data=dati, headers={
        "Authorization": f"Bearer {token}",
        "Content-Type": "application/json",
    })
    with urllib.request.urlopen(req, timeout=15) as r:
        return json.load(r)
urllib è nella libreria standard e copre la maggior parte dei casi; requests è più comodo quando servono sessioni, retry o gestione fine degli header. In entrambi i casi valgono due regole: il token non si scrive nel codice (variabile d'ambiente o gestore di segreti) e ogni chiamata ha un timeout — uno script bloccato su una connessione che non risponde è peggio di uno script che non esiste.
4. Orchestrazione parallela quando i loop non bastano
Il ciclo for va bene fino a venti dispositivi. Con duecento, e un timeout di trenta secondi su ognuno, il tempo di esecuzione supera l'ora e il primo dispositivo irraggiungibile blocca tutto.
Nornir risolve esattamente questo problema e lo dichiara con una metafora efficace: è «il Flask dell'automazione». Si occupa dell'inventario, distribuisce i task ai dispositivi e fornisce un framework comune per i plugin. Il codice che scrivete è Python, non un linguaggio di template: si usano funzioni, strutture dati e librerie normali.
È il salto di livello: da «script che fa una cosa» a «automazione che regge una rete». Va fatto quando il caso 1 e il caso 2 funzionano già da mesi, non prima.
5. Controlli periodici con exit code
L'ultimo caso d'uso è quello che nessuno considera automazione e che invece chiude il cerchio: trasformare un controllo manuale in un comando che restituisce 0 o 1.
import sys
from pathlib import Path

SOGLIA_MB = 500
grandi = [p for p in Path("/var/log").rglob("*.log") if p.stat().st_size > SOGLIA_MB * 1024**2]

for p in grandi:
    print(f"{p} {p.stat().st_size // 1024**2} MB")

sys.exit(1 if grandi else 0)
Un exit code diverso da zero può essere letto da uno scheduler, da un sistema di monitoraggio o da una pipeline. È il modo più semplice per far diventare un controllo parte dell'infrastruttura, senza installare nulla.
L'igiene minima che evita i guai
Cinque abitudini, tutte a costo quasi zero, che distinguono uno script usa e getta da uno strumento che il team può usare:
- Un ambiente virtuale per progetto con le dipendenze elencate in un file. Senza, lo script funziona sulla vostra macchina e in nessun altro posto.
argparseper i parametri, invece di modificare il codice ogni volta:--dry-runcome prima opzione da implementare.loggingal posto diprint, perché un log con timestamp e livello è diagnosticabile, un output a schermo no.- Nessuna credenziale nel codice, mai. Variabili d'ambiente o gestore di segreti.
- Idempotenza: eseguire lo script due volte non deve produrre due volte lo stesso effetto.
L'errore più comune, dopo i primi mesi, è un altro: parsare il testo con le espressioni regolari quando esiste un'API o un formato strutturato (JSON, YAML, XML). Le regex sui comandi CLI si rompono al primo aggiornamento di firmware, e la rottura arriva sempre nel momento peggiore.
Cosa non automatizzare
Vale la pena dirlo, perché è la parte che nessun tutorial affronta: non tutto conviene. Un'attività che si fa due volte all'anno, che richiede giudizio e ha conseguenze difficili da annullare, non è un buon candidato. L'automazione ripaga su ciò che è ripetitivo, verificabile e noioso — e la verifica, in particolare, va progettata prima: se non sapete come controllare che lo script abbia fatto la cosa giusta, non siete pronti ad automatizzarla.
Chi parte da sistemista o da network engineer tende a sottovalutare un ultimo aspetto: l'automazione cambia il lavoro, non lo elimina. Il tempo guadagnato finisce in progettazione e diagnosi, che è esattamente dove serve esperienza di rete — e dove gli strumenti, da soli, non arrivano.
Il percorso Python e automazione IT di Digital Lab srl parte dai primi tre casi di questa lista e arriva all'orchestrazione, con esercizi su apparati reali e attenzione alle credenziali, al logging e alla verificabilità degli script.
Per chi vuole collegare l'automazione alla diagnostica quotidiana, sul blog c'è Troubleshooting di rete: 10 controlli che ogni network engineer dovrebbe saper eseguire, e per la parte di infrastruttura come codice Terraform e Infrastructure as Code: vantaggi, rischi e controlli di sicurezza.