Un annuncio letto di recente: «DevOps Engineer con esperienza SRE per costruire la nostra internal developer platform». Tre mestieri in una riga, e nessuna indicazione su quale dei tre verrà pagato. Chi risponde lo scopre al primo one-to-one.
La confusione è comprensibile: le tre etichette condividono lo stesso arsenale — Git, Kubernetes, Terraform, Prometheus — e nella pratica si sovrappongono per ampie fasce. Descrivono però tre modi diversi di intendere il lavoro, con clienti diversi e metri di successo diversi. Capirlo serve a scegliere una direzione di carriera, a scrivere annunci che non spaventino i candidati giusti e a capire di cosa ha bisogno un'organizzazione prima di aprire una posizione.
Tre risposte allo stesso problema, in momenti diversi
DevOps nasce come reazione a una disfunzione organizzativa: lo sviluppo premiato per le feature rilasciate, le operations premiate per la stabilità, nessuno dei due con un incentivo a collaborare. Il movimento — CALMS, cioè cultura, automazione, lean, misurazione e condivisione, come lo riassume il Google SRE Workbook — non parlava di strumenti ma di confini da abbattere.
SRE arriva dentro Google come applicazione concreta di quella filosofia a un problema specifico: gestire la produzione con metodo da ingegneria del software. Il termine è attribuito a Ben Treynor Sloss e la formula che circola nei libri di Google è «class SRE implements interface DevOps». Un'interfaccia, però, che qualcuno deve implementare, e che impone scelte precise su cosa misurare e come decidere.
Platform engineering è il più giovane dei tre e nasce da un effetto collaterale dei primi due. Quando ogni team di prodotto diventa autonomo sull'infrastruttura, il costo cognitivo si sposta sui team di prodotto: ognuno ricostruisce la propria pipeline, il proprio ambiente, il proprio modo di chiedere un database. Il CNCF Platforms White Paper descrive la piattaforma interna come lo strato che cura e presenta capacità condivise, restituendo ai team di prodotto tempo da spendere sul prodotto.
DevOps: prima la cultura, poi il titolo
Nel quotidiano un DevOps engineer costruisce ciò che rende il rilascio noioso: pipeline di build e test, ambienti riproducibili, infrastruttura dichiarativa, automazione dei deploy, osservabilità di base. Sta dentro o a fianco dei team di prodotto, non in una torre separata.
Il successo si misura sul flusso, non sul singolo servizio. DORA, il programma di ricerca di Google Cloud, ha consolidato cinque metriche: change lead time, deployment frequency, failed deployment recovery time, change fail rate e deployment rework rate, come documenta la guida ufficiale DORA. La vecchia MTTR è stata sostituita dal tempo di recupero di un deploy fallito: una formulazione più stretta e più utile, perché lega la misura a un rilascio che ha rotto qualcosa, non a un incidente qualsiasi.
Il punto debole è noto. Un reparto chiamato «DevOps» può ricreare esattamente il silo che il movimento voleva eliminare. Il titolo resta però una scorciatoia utile per un insieme di competenze che il mercato compra e vende.
SRE: l'affidabilità è una decisione, non un istinto
Un SRE parte da un'idea scomoda per chi ha passato anni a inseguire il 100%: l'affidabilità perfetta è un obiettivo sbagliato. Costa in modo crescente, non lascia margine per cambiare il sistema e non è raggiungibile lungo tutta la catena che separa il servizio dall'utente, come spiega il capitolo 2 del SRE Workbook.
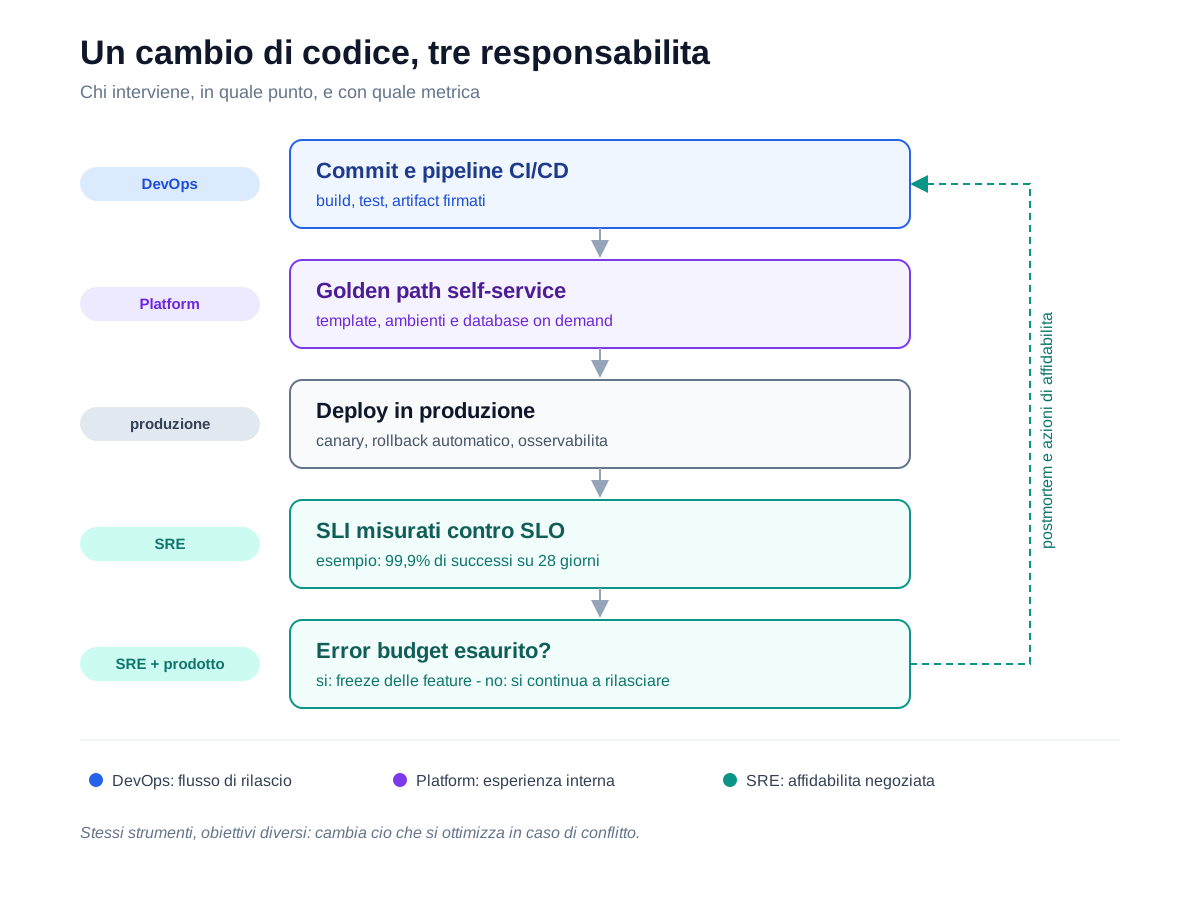
Al suo posto si usano SLI, la misura, e SLO, il bersaglio. Con i numeri del libro: un SLO di disponibilità al 99,9% su tre milioni di richieste in quattro settimane ammette 3.000 richieste fallite. Se un solo incidente ne brucia 1.500, metà del budget è andata. Da qui nasce il meccanismo vero: l'error budget è una risorsa negoziata con il product manager, e quando finisce scatta una politica scritta — priorità ai bug di affidabilità, freeze dei rilasci, o entrambe.
Il resto del mestiere segue: ridurre il toil (Google pone un limite del 50% del tempo per persona), progettare per il fallimento, gestire l'on-call, condurre postmortem senza colpevoli. Il cliente di un SRE sono gli utenti del servizio; il suo interlocutore interno è chi possiede la roadmap.
Platform engineering: la piattaforma è un prodotto, con clienti veri
Un platform engineer non costruisce «l'infrastruttura»: costruisce l'esperienza con cui gli altri team la consumano. Il whitepaper CNCF è esplicito su due punti che spesso si perdono. Primo, la piattaforma dovrebbe essere lo strato più sottile possibile sopra servizi gestiti o team di infrastruttura: il valore sta nelle interfacce e nei golden path, non nel reimplementare un database. Secondo, va trattata come un prodotto — roadmap, feedback, utenti intervistati. Una piattaforma calata dall'alto e imposta per mandato trova resistenza e produce pochi dei benefici promessi.
La metrica si sposta di conseguenza: conta l'adozione (chi la usa e chi smette), il tempo che serve a un nuovo team per arrivare al primo deploy, la soddisfazione degli sviluppatori e, a valle, le metriche DORA dei team che la usano. Un platform team che non sa dire quanti team ha onboardato nell'ultimo trimestre sta facendo operations con un altro nome.
Chi è il cliente, e come si misura il successo
| DevOps | SRE | Platform engineering | |
|---|---|---|---|
| Cliente | team di prodotto | utenti del servizio e business | sviluppatori interni |
| Artefatto | pipeline, infrastruttura come codice | SLO, error budget, postmortem | golden path, portale, API self-service |
| Metrica | metriche DORA di flusso e stabilità | rispetto degli SLO, toil residuo | adozione, tempo al primo deploy |
Le sovrapposizioni sono reali: un platform team scrive pipeline, un SRE automatizza il rollback, un DevOps engineer ragiona di affidabilità. La differenza non sta nel codice scritto ma in ciò che si ottimizza quando due richieste entrano in conflitto.
Quale serve alla tua azienda
Non esiste una risposta valida per tutti, ma alcune euristiche funzionano.
Con meno di venti sviluppatori e un solo prodotto, un platform team dedicato è prematuro: serve qualcuno che sappia fare pipeline e infrastruttura come codice restando dentro il team. Quando i gruppi diventano cinque o sei e ognuno ha il suo modo di creare un ambiente, la piattaforma inizia a ripagarsi — a patto di avere un product manager per la piattaforma, non solo ingegneri.
L'SRE conviene dove l'affidabilità ha un prezzo misurabile: servizi con utenti diretti, vincoli contrattuali o un on-call che sta bruciando le persone. Non serve un team: si parte da un SLO su un servizio e da una politica di error budget scritta in una pagina.
Una nota sulla prassi italiana: molte aziende chiamano «DevOps» chiunque tocchi l'infrastruttura, quindi il titolo sul contratto dice poco. Conta cosa c'è nella job description. Se elenca pipeline, Kubernetes e reperibilità insieme, state cercando tre persone.
Le competenze che restano uguali
Prima della specializzazione la base è condivisa: Linux e networking, Git, un linguaggio di scripting vero (Go o Python), Kubernetes, infrastruttura come codice, osservabilità. Chi ha letto Terraform e Infrastructure as Code riconosce metà del lavoro; chi ha scritto operator Kubernetes ha già toccato il confine tra piattaforma e SRE.
Sul fronte certificazioni i riferimenti seguono lo stesso schema: CKA e CKAD per Kubernetes, AWS Certified DevOps Engineer – Professional o Google Cloud Professional Cloud DevOps Engineer per il cloud, più una certificazione IaC. L'esame Google, per esempio, elenca tra i propri obiettivi l'applicazione delle pratiche SRE e l'equilibrio tra affidabilità e velocità di rilascio: un modo elegante per dire che i tre mondi si toccano. Nessuna certificazione, però, attesta la capacità di negoziare un SLO con un product manager: quella si impara dove i servizi sono in produzione davvero.
Poi la scelta. DevOps è la porta più larga e la più affine a chi ama il flusso di rilascio. SRE chiede metodo e disciplina nel misurare. Platform engineering richiede un gusto da product manager applicato all'infrastruttura, e probabilmente è la competenza più rara delle tre.
Se vuoi costruire queste competenze con un percorso strutturato, il catalogo corsi Digital Lab srl copre le tre aree: dai fondamenti di DevOps e Kubernetes fino alle pratiche SRE e al platform engineering.