L'imbuto di Karpathy: l'AI sembra deludente finché non le dai un problema serio
C'è una frase che torna in quasi ogni riunione in cui si parla di intelligenza artificiale: «l'ho provata, non è niente di speciale». Di solito la pronuncia una persona competente, che ha aperto ChatGPT, ha chiesto il riepilogo di una riunione o una mail da mandare al fornitore, e ha ricevuto un testo corretto e inutile. Non sta sbagliando. Sta usando lo strumento nel modo in cui lo strumento sembra mediocre.
Andrej Karpathy, tra i fondatori di OpenAI e per anni a capo dell'AI di Tesla, ha provato a mettere in fila i livelli di uso reale. Il 9 aprile 2026 ha pubblicato un post su X sul divario di percezione tra chi usa i modelli linguistici e chi li guarda da fuori. Il 11 ottobre è tornato sullo stesso post con una correzione: la distanza non è più tra due gruppi che si parlano addosso, è un imbuto che si stringe.
Quattro gradini, dalla tovaglia al laboratorio
Karpathy lo chiama calcolo «da tovaglia»: stime a spanne, non un censimento. Ma la forma regge.
Circa 6 miliardi di persone, tre quarti dell'umanità, non hanno quasi mai avuto a che fare con un LLM. Altri 1-2 miliardi usano il piano gratuito in modo saltuario e vedono un chatbot goffo, poco più di un motore di ricerca con le buone maniere; in questo gruppo, nota, ci sono anche molti professionisti fuori da matematica e codice, dirigenti compresi, che passano la giornata a parlare con altre persone e conoscono l'AI solo per sentito dire. Poi c'è il gradino che conta: circa 20 milioni di persone, lo 0,2% della popolazione, usano modelli di frontiera per lavoro su codice e matematica e vedono progetti che prima richiedevano settimane chiudersi con un prompt. In cima, circa 5.000 persone con accesso ai sistemi di frontiera dall'interno delle aziende che li costruiscono, dove si parla di migliaia di agenti che collaborano per settimane.
Il numero che spaventa non è 20 milioni: è che 20 milioni su 8 miliardi fa lo 0,2%.
Perché l'imbuto si stringe
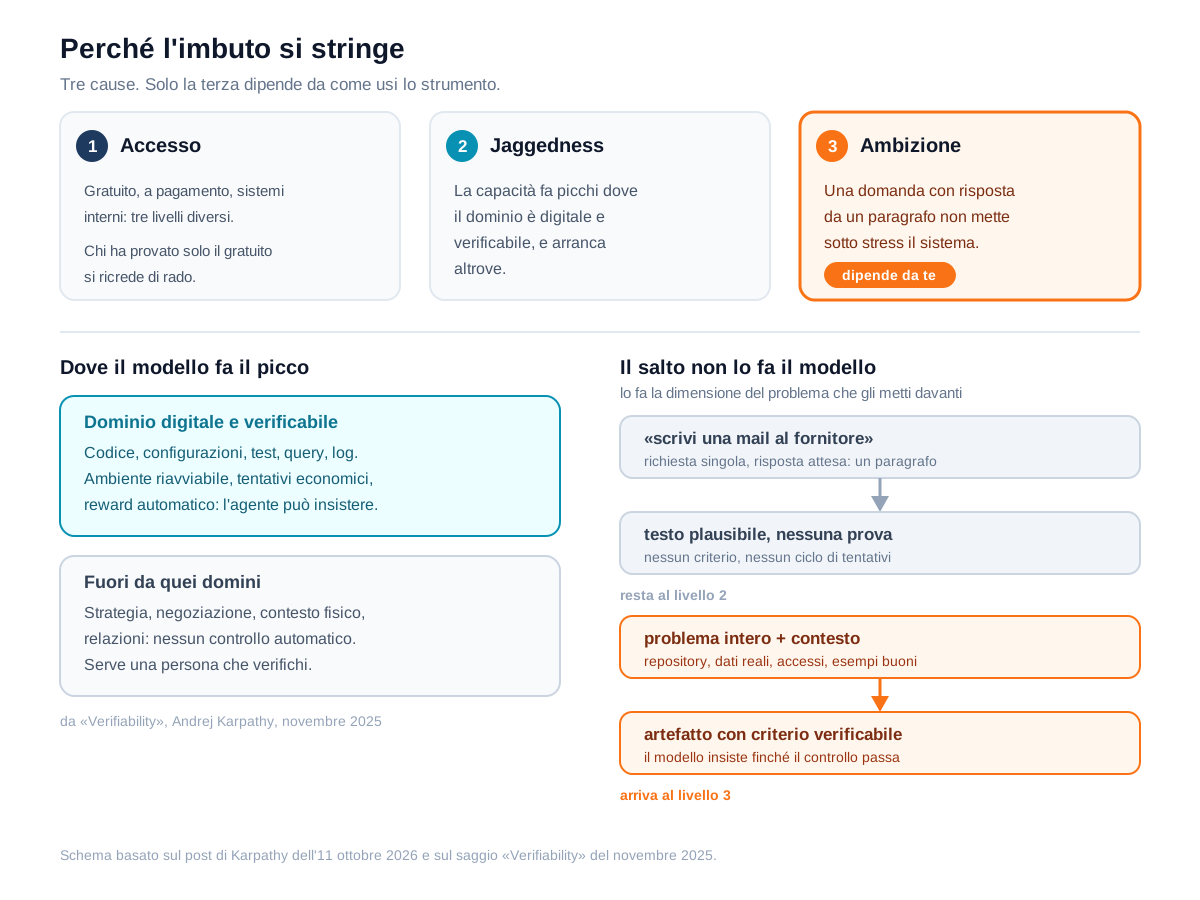
Karpathy indica tre cause, e solo una riguarda la qualità dei modelli.
L'accesso. Piano gratuito, piano a pagamento, sistemi interni. Chi usa la versione gratuita di un chatbot, magari provata una volta l'anno scorso, si è fatto un'idea di cosa sia un modello linguistico e difficilmente la rivede.
La jaggedness, la forma a schegge. È il punto più tecnico e il più utile. Nel saggio Verifiability del novembre 2025 Karpathy riassume la faccenda in due righe: il software scritto a mano automatizza ciò che sai specificare, le reti neurali addestrate automatizzano ciò che sai verificare. Un compito è addestrabile in modo aggressivo quando l'ambiente è riavviabile, economico da provare e capace di dare un reward automatico a ogni tentativo. Dove queste tre condizioni ci sono — matematica, codice, puzzle con una risposta giusta — la capacità fa un picco verticale. Dove non ci sono, arranca. Nel bilancio sull'anno LLM 2025 la descrizione è memorabile: lo stesso sistema è insieme un genio polimata e un bambino delle elementari confuso, a pochi secondi di distanza.
L'ambizione del problema. Una domanda la cui risposta sta in un paragrafo non mette sotto stress niente. Serve un serbatoio di problemi grandi, difficili, che ti interessano davvero. Questa è la causa che dipende da chi usa lo strumento, non da chi lo costruisce.
Il salto non lo fa il modello, lo fa la dimensione del compito
Prendiamo due richieste fatte allo stesso modello, nello stesso pomeriggio.
La prima: «scrivimi una mail per chiedere lo stato della consegna al fornitore». Risultato: tre paragrafi educati, nessun errore, nessun valore. Il modello non ha sbagliato niente, ma non aveva nulla da sbagliare. La richiesta non conteneva un criterio di successo verificabile in autonomia e non richiedeva nessun giro di tentativi. La persona che chiude la finestra e conclude che l'AI è sopravvalutata ha ragione rispetto a quell'esperienza.
La seconda: «questo report deve uscire ogni lunedì alle 7, leggere i tre export dei fornitori, riconciliare gli importi con gli ordini di acquisto, fermarsi e avvisare su Teams se lo scarto supera l'1%, e salvare l'esito in una cartella condivisa». Qui c'è un confine, ci sono dati reali, c'è un criterio che si può controllare senza chiedere al modello come è andata, e c'è spazio per iterare: la prima versione sbaglia una colonna, la seconda sbaglia il fuso orario, la terza funziona. Il salto di qualità non è arrivato dal modello: è arrivato dalla struttura del problema.
La differenza tra le due richieste si può riassumere così: la prima chiede un testo, la seconda chiede un artefatto con una prova di correttezza. Un artefatto ha un ciclo di feedback. Un testo no.
Perché in IT la leva è più alta che altrove
La jaggedness è una brutta notizia per chi lavora in ambito creativo o strategico e una buona notizia per chi lavora su infrastrutture. Configurazioni di rete, manifest Kubernetes, moduli Terraform, playbook Ansible, query SQL, log applicativi: sono tutti domini digitali, con esiti controllabili e ambienti che si possono riprodurre. Sono esattamente i posti dove i modelli fanno i picchi.
Tradotto in pratica: un playbook Ansible da rifattorizzare, un modulo Terraform da ripulire, quattrocento righe di log da triage dopo un incidente, la suite di test che nessuno ha mai scritto. Non sono compiti glamour, ma sono compiti verificabili, e quindi compiti dove l'agente può insistere finché il risultato non passa. Chi scrive automazione in Python lo sa già: il ciclo «scrivi, esegui, leggi l'errore, correggi» è il motivo per cui l'automazione IT è il primo posto dove questi strumenti rendono.
Verificabile, però, non significa verificato. Un rischio concreto del livello 3 è che chi lavora veloce smetta di controllare, proprio perché il modello sembra sempre sul pezzo. Le regole di ingaggio — chi approva cosa, quali dati possono entrare nel contesto, cosa deve restare tracciato — vanno decise prima, non dopo il primo incidente. Ne abbiamo scritto parlando di governance dell'AI in azienda.
Quattro passi per portare una persona dal livello 2 al 3
Il passaggio da «uso il chatbot» a «gli do un problema intero» non si insegna a parole, e nemmeno con un corso sullo strumento. Si fa sui problemi veri, con un metodo che assomiglia più alla formazione sul campo che alla lezione frontale.
- Parti da un problema che appartiene già a quella persona. Non un progetto demo, non un caso di scuola: la cosa che le sta sulle scrivanie da mesi. Chi amministra le ferie rifà il foglio delle ferie; chi segue gli acquisti automatizza il controllo delle fatture. La motivazione non è l'entusiasmo per la tecnologia, è il fastidio per un compito stupido.
- Definisci il criterio di verifica prima di iniziare. «Funziona» non è un criterio. «Per venti ordini campione il totale coincide al centesimo, e sugli altri si ferma e mi avvisa» lo è. Se non riesci a scrivere il criterio, il problema è troppo vago perché un agente ci lavori.
- Dai contesto, non istruzioni. Repository, accessi, esempi di output buoni, il file Excel che circola da anni. Il modello non conosce la tua azienda; l'unico modo per trasferirla è il contesto che gli metti davanti.
- Accetta che la prima versione sia brutta. La maggior parte delle persone abbandona qui, al primo errore, perché legge l'errore come un verdetto sul modello invece che come un giro del ciclo. Chi ha esperienza di debug riconosce l'errore per quello che è: informazione.
Su quest'ultimo punto vale la pena essere espliciti, perché è il motivo per cui tanta formazione sull'AI non produce effetti. Un corso che insegna dieci trucchi di prompting produce utenti di livello 2 più efficienti. Un percorso che mette una persona davanti a un problema abbastanza grande da richiedere un artefatto produce qualcosa di diverso: qualcuno che sa decidere quale pezzo del proprio lavoro vale la pena delegare, e come accorgersi se il risultato è sbagliato. La seconda competenza è molto più vicina a quelle che si imparano in un percorso su dati e metodi che a un elenco di comandi — la stessa differenza che passa tra saper usare un foglio di calcolo e saper impostare un'analisi, che è il tema di questo articolo sulla data science.
Cosa resta fuori dall'imbuto
Karpathy chiude il post con un'immagine che vale più dei numeri: la comprensione umana comincia a restare indietro. Nel livello più alto si producono artefatti che nessuno riesce a leggere per intero, e la revisione diventa archeologia. Fuori dai laboratori il problema si presenta in scala minore ma con la stessa forma: un agente apre una pull request da quattrocento righe, il revisore la approva perché i test passano, e nessuno sa più spiegare perché quel codice funziona.
È qui che il divario smette di essere una questione di tool e diventa una questione di organizzazione. Chi forma un team oggi ha due strade: insegnare l'ennesimo trucco per far scrivere meglio una mail, oppure mettere in mano alle persone un problema abbastanza grande da richiedere uno strumento, un criterio di verifica e un giro di iterazioni. La prima strada è comoda e non sposta nessuno dal livello 2. La seconda è scomoda, richiede tempo e qualcuno che sappia accompagnare il primo tentativo, e sposta.
Se vuoi capire da dove partire, il catalogo dei nostri percorsi è su tutti i corsi Digital Lab: si va dalle basi di automazione e cloud fino ai percorsi su AI e dati, con la stessa impostazione pratica che serve a portare un problema reale dentro lo strumento.