Un venerdì pomeriggio qualsiasi la dashboard si riempie di errori 5xx e l'endpoint pubblico smette di rispondere. Non c'è nessun attacco in corso: è un servizio che ha smesso di reggere il carico. La prima domanda in call è sempre la stessa — quanto ci vuole per tornare su? Se la risposta è «dipende», il problema non è l'incidente: è che il ripristino non è mai stato progettato.
In AWS il disaster recovery non si compra, si progetta. Significa decidere quanti dati si è disposti a perdere, quanto downtime tollerare, dove ricostruire l'ambiente e come spostare il traffico. La documentazione ufficiale descrive quattro strategie ordinate per costo, complessità e tempi di recupero (Disaster recovery options in the cloud). Vanno lette come una scala di compromessi, non come un menu da cui scegliere la voce che costa meno.
RTO e RPO: due numeri, non due slogan
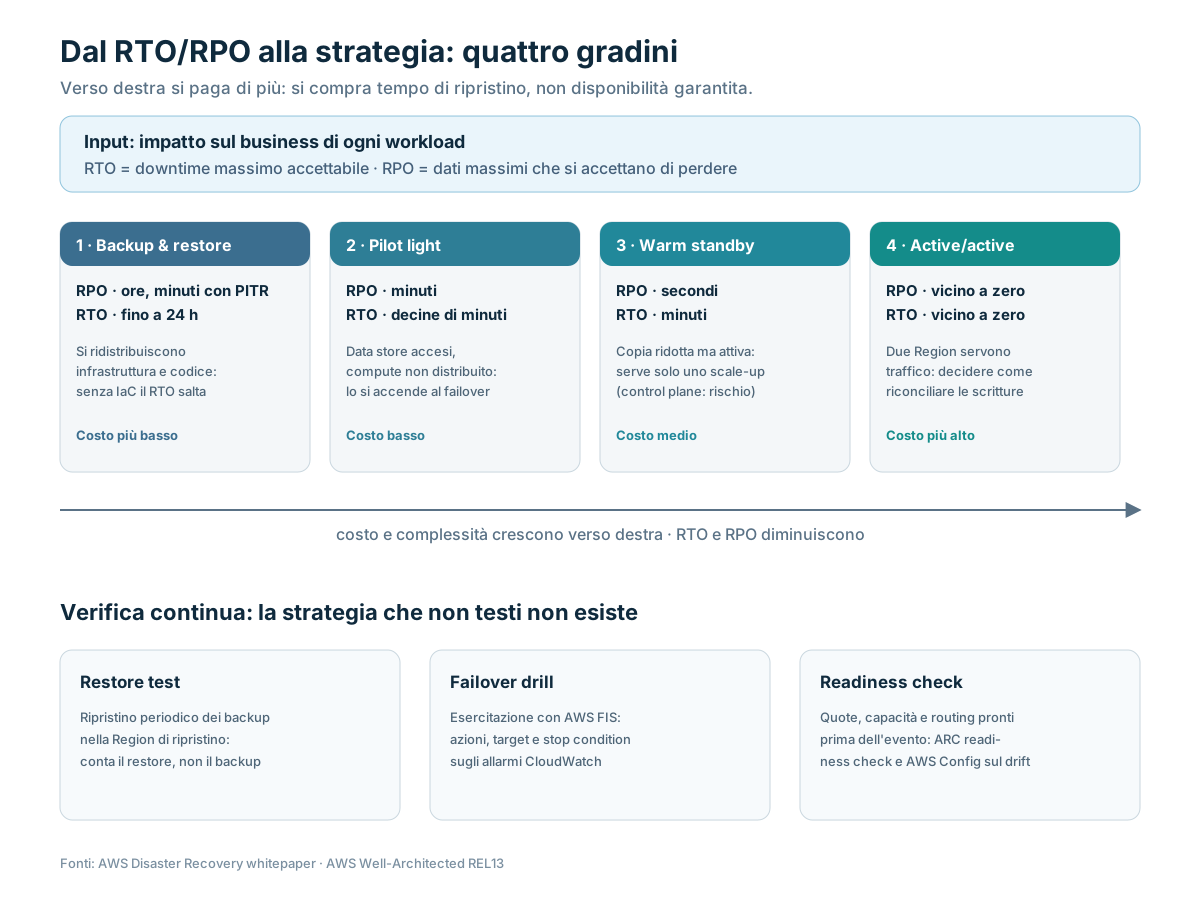
Il Well-Architected Framework li definisce in modo secco. Il RTO (Recovery Time Objective) è il ritardo massimo accettabile tra l'interruzione del servizio e il ripristino; il RPO (Recovery Point Objective) è la quantità massima di dati che si accetta di perdere, misurata all'indietro dall'ultimo punto di recupero disponibile (REL13-BP01).
Il punto interessante non è la definizione, è il metodo. Il framework suggerisce di partire dall'impatto sul business, non dalla tecnologia: ricavi persi, reputazione, obblighi normativi, e solo alla fine la fattibilità tecnica. Le aziende che conosco sbagliano quasi sempre nello stesso modo, dichiarando lo stesso RTO per tutti i workload. Un gestionale che fattura e un ambiente di reportistica notturna non hanno lo stesso valore, e trattarli allo stesso modo porta a pagare infrastruttura inutilmente o, peggio, a proteggere il sistema sbagliato.
Due domande che vale la pena farsi prima di scrivere qualunque architettura:
- Quale RTO serve davvero a chi usa il servizio, non a chi lo amministra?
- Le dipendenze a valle riescono a rispettare lo stesso obiettivo? Un'applicazione con RTO di un'ora che chiama un servizio con RTO di sei ore ha, di fatto, un RTO di sei ore.
Availability Zone o Region: non è lo stesso disastro
Prima di scegliere la strategia va chiarito contro cosa ci si sta proteggendo. Un'architettura multi-AZ distribuita su tre zone di disponibilità regge la perdita di un data center — incendio, allagamento, guasto elettrico esteso. Per un workload ben architettato questo è spesso sufficiente, e non richiede alcun failover geografico: il bilanciatore smette di mandare traffico alla zona malata e il resto continua.
Se invece il disastro atteso è la perdita di un'intera Region, o se un requisito normativo impone la continuità tra siti distinti, allora servono Pilot Light, Warm Standby o Multi-Site Active/Active (REL13-BP02).
C'è un caso da tenere presente: i workload soggetti a requisiti di residenza dei dati in località servite da una sola Region AWS non possono usare il multi-Region. In quel caso multi-AZ resta la risposta corretta, e conviene dirlo esplicitamente nel documento di architettura invece di scoprirlo durante un audit.
Le quattro strategie
| Strategia | RPO tipico | RTO tipico | Cosa resta acceso in recovery |
|---|---|---|---|
| Backup and restore | ore (minuti con point-in-time recovery) | fino a 24 ore | solo lo storage dei backup |
| Pilot light | minuti | decine di minuti | data store e replica |
| Warm standby | secondi | minuti | copia ridotta ma funzionante |
| Multi-site active/active | vicino a zero | vicino a zero | tutto, in due Region |
Backup and restore è l'unica strategia che serve sempre, anche quando se ne sceglie un'altra. I dati vengono salvati e copiati in un'altra Region, ma infrastruttura e codice vanno ridistribuiti al momento del bisogno: senza infrastructure as code il ripristino diventa una sequenza di click e il RTO promesso evapora. Se hai già investito in Terraform, il tema è noto e vale la pena leggere i controlli di sicurezza in Terraform e Infrastructure as Code. Oltre ai dati vanno protette anche le AMI e la configurazione.
Pilot light replica i dati in un'altra Region e tiene accesa solo l'infrastruttura minima: database, object storage, networking. Il compute non si spegne, semplicemente non viene distribuito finché non serve. La documentazione AWS è esplicita su questo punto — «spento» significa non distribuito — ed è la differenza che tiene bassi i costi. Al failover si promuove il database. Attenzione: con RDS la promozione di una read replica cross-Region richiede qualche minuto e un riavvio; con Aurora Global Database la promozione di una Region secondaria avviene in meno di un minuto anche in caso di perdita totale della Region primaria.
Warm standby è Pilot light un passo più avanti: in recovery gira una copia completa ma ridotta, già in grado di servire traffico. Il failover si riduce a uno scale-up. Qui emerge il compromesso più interessante, che raramente viene messo sul tavolo: Auto Scaling è un'operazione di control plane, e dipendere dal control plane durante il ripristino abbassa l'affidabilità complessiva. Se serve un RTO molto basso si può scegliere un hot standby con capacità già dimensionata — più caro, più prevedibile.
Multi-site active/active non ha failover: entrambe le Region servono traffico, e «disastro» significa evacuare una Region e reggere il carico con l'altra. È la strategia più costosa e complessa, e diventa davvero complessa quando si scrive su più Region: scritture globali con una Region che accetta tutte le write, scritture locali con riconciliazione (DynamoDB global tables usano last writer wins), oppure scritture partizionate per chiave. È una decisione di prodotto prima che tecnica.
Spostare il traffico senza dipendere dal control plane
La parte che nei progetti viene lasciata per ultima è quella che si usa per prima durante un incidente. Route 53 con health check sposta il traffico su base DNS e lavora sul data plane, quindi con un'affidabilità più alta di qualunque API di configurazione. ARC (Application Recovery Controller) aggiunge routing control, cioè health check che non controllano nulla e funzionano come interruttori comandati via API, più regole di sicurezza che impediscono di attivare due repliche insieme (What is ARC).
AWS Global Accelerator evita i problemi di cache DNS e porta il traffico sulla rete AWS prima possibile; il traffic dial però è un'operazione di control plane. CloudFront fa failover per singola richiesta sull'origine, che è utile ma non sostituisce un piano di ripristino.
Una regola pratica: il failover automatico basato su health check va usato con cautela, perché un falso allarme costa comunque disponibilità e dati. Più spesso conviene l'attivazione manuale con passaggi automatizzati — un pulsante, non un runbook da interpretare. E il failback va scritto nello stesso playbook del failover: dopo un evento la Region di ripristino è quella con i dati aggiornati, e riportare tutto indietro è un'operazione a sé.
La replica non è un backup
Questa è la distinzione che causa più danni. La replica continua protegge da alcuni tipi di disastro, non dalla corruzione dei dati né da una cancellazione malevola: se il dato sbagliato viene replicato, arriva anche in recovery. Servono entrambe le cose. Versioning su S3, che conserva la versione precedente di un oggetto sovrascritto; backup point-in-time nella Region di ripristino; copie cross-account, che proteggono anche dal compromesso delle credenziali dell'account principale. Un dettaglio utile: l'eliminazione di un oggetto in S3 crea un delete marker solo nel bucket sorgente, quindi la copia in DR resta protetta.
Testare: l'unico percorso che funziona è quello che eserciti
La frase più onesta della documentazione AWS è che l'unico ripristino che funziona è il percorso che si prova spesso (Testing disaster recovery). Aggiunge un secondo punto che riguarda quasi tutti i progetti reali: le quote di servizio nella Region di ripristino. Una capacity che bastava sei mesi fa può non bastare oggi, e le quote non si alzano da sole.
Due strumenti aiutano a non affidarsi alla buona volontà. AWS Fault Injection Service esegue esperimenti di fault injection con azioni, target e stop condition basate su allarmi CloudWatch, così un test di failover resta circoscritto e si interrompe da solo se peggiora (What is AWS FIS). AWS Resilience Hub valuta l'applicazione rispetto agli obiettivi dichiarati e può lanciare esperimenti FIS al posto tuo (What is AWS Resilience Hub). In mezzo resta il game day: un venerdì in cui qualcuno stacca davvero la Region primaria e il team esegue il runbook senza scorciatoie.
Il drift è il nemico silenzioso: AMI vecchie, security group cambiati a mano, policy IAM aggiornate solo in produzione. AWS Config registra le configurazioni e può segnalare la deriva, ma qualcuno deve guardare il segnale.
Gli errori che tornano sempre
- RTO dichiarati in un documento e mai misurati in un test.
- Quote non alzate nella Region di ripristino, e capacità che non arriva quando serve.
- Un solo account per produzione e recovery: un compromesso delle credenziali diventa un disastro senza ripristino.
- Backup creati con puntualità e mai ripristinati. Un restore programmato è anche un modo per scoprire che il backup non era completo.
- Runbook scritti una volta e non più toccati, con nomi di persone che nel frattempo hanno cambiato team.
Se il tema delle responsabilità condivise e della gestione degli accessi ti interessa, AWS IAM spiegato è un buon complemento, e il Well-Architected Framework offre il quadro completo per valutare affidabilità e costi insieme, che è esattamente il trade-off di ogni strategia di DR.
Da dove iniziare lunedì
Scegli un workload critico, scrivi il suo RTO e il suo RPO con il business, verifica quanto costerebbe raggiungerli con Pilot Light e con Warm Standby, e poi prova un restore dalla copia in DR. Quasi sempre il primo test cambia le priorità più di qualunque architettura sulla carta.
Se vuoi costruire queste competenze su basi solide, il catalogo corsi AWS copre architettura, affidabilità e servizi di ripristino con laboratori pratici.